2. 커뮤니케이터
커뮤니케이터는 모든 연산이 받는 핸들입니다. 이 장은 랭크들이 서로를 찾아 커뮤니케이터를 만드는 과정과 그 수명을 다룹니다.
2.1 부트스트랩 순서
랭크는 스스로 서로를 발견할 수 없습니다. 한 랭크가 핸들을 만들고 런처가 배포하면 나머지가 그것으로 접속합니다.
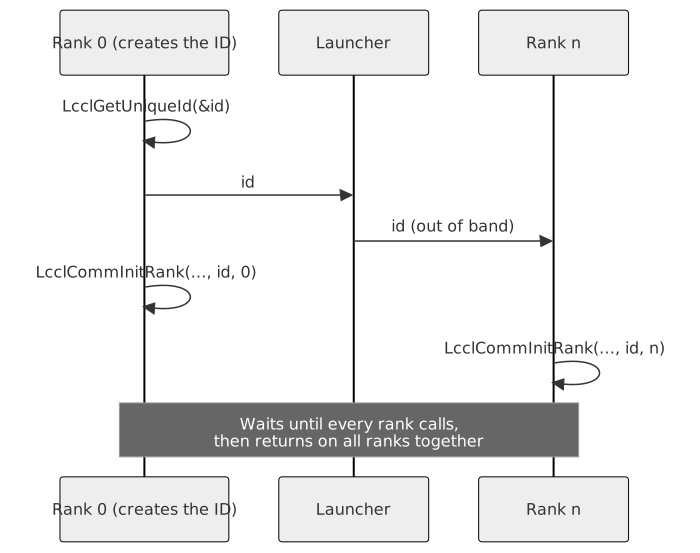
LcclGetUniqueId()는 한 랭크에서 한 번만 호출합니다. 128바이트 핸들을 반환하며, 이 핸들을 만든 프로세스는 모든 랭크가 접속을 마칠 때까지 살아 있어야 합니다. 나머지 모든 랭크는 LcclCommInitRank()를 호출하기 전에 정확히 같은 핸들을 받아야 합니다. 서버가 여럿이면 다른 서버가 핸들을 만든 서버에 네트워크로 접속할 수 있어야 합니다. 다중 노드 실행을 보십시오.
고유 ID 배포는 사용자의 책임입니다
라이브러리는 핸들을 배포하지 않습니다. 런처가 이미 가진 수단(MPI broadcast, 공유 파일, 환경 변수, 키-값 저장소)을 사용하십시오. Python에서는 bytes(unique_id.internal)로 128바이트를 꺼내 보내고, 받은 쪽에서 lccl.LcclUniqueId(data)로 되살립니다. 핸들 객체 자체는 pickle로 보낼 수 없습니다.
한 핸들은 커뮤니케이터를 하나 만드는 데 한 번만 씁니다. 모든 랭크가 접속하고 나면 그 핸들은 더 접속을 받지 않으므로, 이미 쓴 핸들로 다시 접속하면 kLcclSocketNotConnect로 실패합니다. 커뮤니케이터를 새로 만들 때마다 새 핸들을 만드십시오.
랭크가 어긋나면 에러 없이 멈춥니다
랭크가 모이길 기다리는 동안에는 타임아웃이 없습니다. 아래 경우에 LcclCommInitRank()가 반환되지 않습니다. 로그는 핸들을 만든 프로세스 쪽에 남습니다.
| 상황 | 로그 |
|---|---|
| 두 랭크가 서로 다른 핸들을 받았다 | 없음. 핸들마다 따로 모이므로, 각 핸들이 nranks개가 모이길 기다립니다 |
nranks만큼 랭크가 모이지 않았다 |
없음 |
랭크마다 nranks가 다르다 |
Bootstrap Root : mismatch in rank count from procs N : M(ERROR)을 남기고 접속 대기를 끝냅니다 |
| 같은 랭크 번호로 두 번 접속했다 | rank N of M ranks has already checked in(ERROR)을 남기고 접속 대기를 끝냅니다 |
접속 대기가 오류로 끝나면 아직 접속하지 못한 랭크는 소켓 오류로 실패하고, 이미 접속한 랭크는 계속 기다립니다. 핸들을 만든 프로세스가 아직 접속을 기다리는 중인지는 그 프로세스에서 lccl.bootstrap_is_root_alive()로 확인할 수 있습니다(1이면 기다리는 중).
2.2 커뮤니케이터 생성
각 프로세스가 자신의 랭크 인덱스로 커뮤니케이터를 만듭니다. 여러 서버로 확장되는 유일한 구성이고 서빙 프로세스의 일반적인 배포 형태와도 맞습니다. torch.distributed도 이 구성입니다.
1 2 | |
단일 프로세스가 모든 커뮤니케이터를 한 번에 만듭니다. 프로세스 사이 랑데부가 없으므로 고유 ID를 따로 다루지 않습니다.
1 | |
테스트와 한 서버 안의 작업에 편리합니다. 호출하는 스레드에 먼저 디바이스를 바인딩해야 하고(아니면 kLcclMemDeviceAllocFail로 실패합니다), Python에서는 len(devlist)가 ndev와 같아야 합니다. 호출이 실패하면 그 프로세스에서는 LCCL을 더 쓰지 말고, 원인을 고친 뒤 새 프로세스에서 다시 시작하십시오. 서버 사이로는 확장되지 않으며, 서버마다 프로세스 하나가 그 서버의 카드를 모두 맡는 구성은 지원하지 않습니다.
이렇게 만든 커뮤니케이터를 한 스레드에서 쓸 때는 각 연산을 group_start()와 group_end()(C++은 LcclGroupStart()와 LcclGroupEnd()) 사이에서 커뮤니케이터마다 한 번씩 호출하십시오(그룹). 그룹 없이 차례로 부르면 첫 호출이 나머지 랭크를 기다리다가 워치독에 끊겨 kLcclKernelSpinTimeout으로 실패하고, 커뮤니케이터를 다시 만들어야 합니다.
커뮤니케이터를 만들기 전에 디바이스를 고르십시오
호출 스레드에 지금 바인딩된 디바이스가 이 랭크의 디바이스가 됩니다. Python은 hart.set_device(), C++은 HaSetDevice()를 먼저 부르십시오. 빠뜨리면 LcclCommInitRank()가 Communicator unknown or unclassified error(kLcclCommError)로 실패합니다. 같은 서버의 두 랭크가 같은 카드를 잡았을 때도 같은 코드로 실패하고, 로그에 Duplicate LPU detected가 남습니다. 한 서버에서 한 카드는 랭크 하나만 잡을 수 있습니다.
Python은 랭크마다 프로세스를 따로 두고, fork가 아니라 spawn으로 띄우십시오
바인딩의 블로킹 호출은 GIL을 놓지 않습니다. 한 프로세스 안에서 스레드마다 랭크 하나를 맡기면 한 스레드가 상대를 기다리는 동안 다른 스레드가 실행되지 못해 교착됩니다. 그리고 런타임을 초기화한 프로세스를 fork하면 자식이 런타임의 스레드와 락을 물려받아 안전하지 않으므로, multiprocessing.get_context("spawn")처럼 새 인터프리터로 띄우십시오.
C++에서는 스레드마다 랭크 하나를 맡길 수 있습니다. 각 스레드가 자기 디바이스를 HaSetDevice()로 고른 뒤에 LcclCommInitRank()를 호출하십시오. 한 스레드에서 차례로 부르면 첫 호출이 나머지 랭크를 기다리며 반환되지 않으므로, 위처럼 랭크마다 스레드나 프로세스를 두십시오.
LPU에서 LcclCommInitAll은 호출 스레드의 카드를 씁니다
LcclCommInitAll()은 모든 랭크의 장치 쪽 보조 자원을 호출 스레드에 바인딩된 디바이스 하나에 할당합니다. 그래서 카드가 여러 장인 LPU에서는 랭크 수만큼의 자원이 한 카드에 놓입니다. 자원이 랭크마다 각자의 카드에 놓여야 하는 구성에서는 위처럼 랭크마다 스레드나 프로세스를 두고 LcclCommInitRank()를 쓰십시오.
명시적 설정으로 생성
LcclCommInitRankConfig()는 기본값을 바꿔야 하는 호출자를 위해 LcclConfig를 받습니다. Python 바인딩에는 없습니다.
| 필드 | 기본값 | 설명 |
|---|---|---|
blocking |
1 |
0이면 논블로킹입니다. 커뮤니케이터 생성, LcclCommFinalize(), 연결이 필요한 그룹의 제출이 kLcclInProgress로 먼저 돌아올 수 있습니다. LcclCommDestroy()와 LcclCommAbort()는 그룹 밖에서는 호출 안에서 끝납니다 |
min_num_chnl |
1 |
채널 수 하한 |
max_num_chnl |
8 |
채널 수 상한 |
net_name |
자동 | 네트워크 백엔드 이름("IB", "Socket"). NULL이면 자동 선택 |
LCCL_BLOCKING, LCCL_MIN_CHANNELS, LCCL_MAX_CHANNELS, LCCL_NET 환경 변수는 같은 필드를 덮어씁니다. 환경 변수를 보십시오.
LcclConfig는 제공된 초기화 매크로로 초기화해야 합니다
구조체에는 라이브러리가 검증하는 필드가 있습니다. 0으로 초기화했거나 일부만 채운 config는 kLcclInvalidArgument로 거부됩니다. LCCL_CONFIG_INITIALIZER에서 시작해 바꾸려는 필드만 설정하십시오. 센티넬 값으로 남은 필드는 라이브러리 기본값을 따릅니다.
값도 검증합니다. blocking은 0이나 1이어야 하고, 채널 수는 양수여야 합니다. min_num_chnl만 설정하고 max_num_chnl을 센티넬로 두면 min_num_chnl > max_num_chnl로 판정되어 거부되므로 두 필드를 함께 설정하십시오.
2.3 커뮤니케이터 조회
| 진입점 | 반환 |
|---|---|
LcclCommCount() |
랭크 수 |
LcclCommUserRank() |
이 랭크의 인덱스 |
LcclCommHaDevice() |
이 커뮤니케이터가 구동하는 디바이스 |
LcclCommGetAsyncError() |
커뮤니케이터에 기록된 비동기 오류 |
Python의 LcclComm 객체는 읽기 전용 속성 rank, n_ranks, ha_dev, node, n_nodes, local_rank, local_ranks, n_channels를 노출합니다. n_nodes로 랭크가 몇 대의 서버에 퍼졌는지, n_channels로 실제 채널 수를 확인할 수 있습니다.
LcclCommGetAsyncError()는 두 경우에 필요합니다.
- 논블로킹 커뮤니케이터(
blocking = 0). 호출이kLcclInProgress로 먼저 돌아오고, 작업의 결과는 이 값에 기록됩니다.kLcclSuccess가 될 때까지 확인하십시오. kLcclKernelAborted가 반환된 경우. 통신 경로 내부에서 난 실패는 그 원인 코드가 이 값에 기록됩니다. 실패한 연산은 원인 코드를 그대로 돌려주지만,kLcclKernelAborted를 받았다면 이 값을 읽어 원인을 확인하십시오.
기본(블로킹) 커뮤니케이터에서 집합 연산은 반환될 때 이미 끝나 있으므로 성공 반환을 완료로 읽으면 됩니다. 이 값은 한 번 기록되면 지워지지 않습니다. 오류가 기록된 커뮤니케이터는 다시 만들어야 합니다. 그중 논블로킹 커뮤니케이터는 LcclCommAbort()로 해제하십시오.
2.4 정리
| 진입점 | 용도 |
|---|---|
LcclCommFinalize() |
남은 작업을 마치고 커뮤니케이터를 정지. 자원은 해제하지 않음 |
LcclCommDestroy() |
해제. 정상 경로 |
LcclCommAbort() |
남은 작업을 기다리지 않고 중단시킨 뒤 해제 |
LcclCommAbort()는 피어가 사라져 정상 종료가 영원히 블로킹되는 경우를 위한 것입니다. 이 커뮤니케이터에서 진행 중인 연산을 중단시키고 자원을 회수합니다. LcclCommDestroy()와 LcclCommAbort()는 둘 다 자원을 해제하므로 한 핸들에 하나만 호출하십시오. 호출한 뒤 그 핸들은 쓸 수 없습니다.
Python 바인딩에는 comm_destroy()만 있고 LcclCommAbort()와 LcclCommFinalize()는 노출되어 있지 않습니다.
한 랭크에서만 커뮤니케이터를 파괴하는 경우
정리는 그렇게 보이지 않아도 효과상 집합 연산입니다. 한 랭크가 파괴하는 동안 다른 랭크들이 계속 집합 연산을 호출하면 그 랭크들이 상대를 기다리며 멈추고, 워치독(LCCL_KERNEL_TIMEOUT_MS, 기본 5초)이 끊을 때까지 이어집니다. 랭크를 함께 내리거나 모두 abort하십시오.
한 프로세스 안에 같은 커뮤니케이터에 속한 랭크 여러 개가 있을 때(LcclCommInitAll이나 스레드마다 랭크를 맡긴 구성)는 그 랭크들을 모두 파괴하거나 abort해야 자원이 실제로 해제됩니다. 일부만 정리하면 나머지가 끝날 때까지 자원이 남습니다. 서로 다른 커뮤니케이터(텐서 병렬용과 파이프라인 병렬용 등)는 각각 따로 해제됩니다.
2.5 수명 규칙
- 커뮤니케이터는 생성 시점에 호출 스레드에 바인딩된 디바이스에 묶입니다. 다른 디바이스가 바인딩된 스레드에서 호출하지 마십시오. 새로 만든 스레드에는 바인딩된 디바이스가 없습니다. 커뮤니케이터를 만든 스레드가 아닌 스레드(랭크 스레드를 join한 뒤의 메인 스레드 등)에서 연산이나 정리 함수(
LcclCommFinalize(),LcclCommDestroy(),LcclCommAbort(), Python의comm_destroy())를 호출하려면 그 스레드에서 먼저HaSetDevice()(Python은hart.set_device())로 커뮤니케이터의 디바이스를 고르십시오. - 핸들은 참조 카운트되지 않습니다. 파괴 즉시 무효가 되며, 이후 사용은 라이브러리가 감지할 수 있으면
kLcclInvalidArgument를, 감지할 수 없으면 정의되지 않은 동작을 낳습니다. - Python의
LcclComm은 가비지 컬렉터가 해제하지 않습니다. 반드시comm_destroy()를 부르십시오.try/finally로 감싸면 예외 경로에서도 정리됩니다. - 한 커뮤니케이터를 쓰는 호출은 한 번에 하나만 진행되도록 직렬화하십시오. 스레드마다 서로 다른 랭크의 커뮤니케이터를 맡기는 구성은 확인했지만, 한 커뮤니케이터를 여러 스레드가 동시에 쓰는 구성은 확인하지 않았습니다.
- 하나의 프로세스가 서로 다른 랭크 집합에 커뮤니케이터를 여럿 가질 수 있습니다. 텐서 병렬과 파이프라인 병렬이 각자 커뮤니케이터를 갖는 형태가 그 예입니다. 같은 랭크 집합 위에 커뮤니케이터를 여러 개 만드는 구성은 확인하지 않았습니다.