5. Paged KV 캐시¶
vLLM 스타일 paged attention은 요청이 길어질 때마다 KV 캐시를 덧붙입니다.
요청별 KV 주소는 HW 페이지 단위로 물리 풀의 주소로 변환되며, torch.ops.lpu.vmm_* 연산이 런타임
VMM API를 거쳐 이 HW 페이지를 관리합니다. 사용자는 HW 페이지를 직접 다루지 않고 이 연산만 호출합니다.
upstream vLLM의 커널은 블록 테이블(block table)로 KV 블록을 찾습니다. LPU에서는 요청 슬롯마다 KV 주소가 있고, 하드웨어가
HW 페이지 단위로 주소를 변환합니다.
이 연산들은 주로 vLLM 통합의 워커가 호출하며, 직접 호출하는 경우는 서빙 엔진이나 KV 커넥터를 작성할 때입니다.
Contents¶
| Section | Objective |
|---|---|
| 5.1 구성 요소 | 풀, KV 주소 텐서, 매핑이 각각 무엇인지 |
| 5.2 풀 만들기 | 풀 텐서의 형상, 초기화, 수명 |
| 5.3 초기화 순서 | 예약, 풀 생성, VMM 상태 초기화 순서 |
| 5.4 스텝마다 매핑 | unmap → map 인자 |
| 5.5 vLLM에서의 흐름 | 워커가 실제로 부르는 순서 |
| 5.6 규칙 | 풀 수명, 커널 완료 |
5.1 구성 요소¶
| 구성 요소 | 만드는 연산 | 역할 |
|---|---|---|
| 풀 | vmm_create_kv_pool |
KV를 담는 물리 메모리. KEY와 VALUE가 dim 0으로 나뉨 |
| KV 주소 텐서 | vmm_reserve (KEY, VALUE 각각) |
커널이 KV를 읽는 주소. 물리 메모리 없이 주소만 가짐 |
| 디바이스 VMM 상태 | vmm_init_blocks |
풀로 디바이스 VMM 상태를 초기화. 디바이스당 하나 |
| 매핑 | vmm_map_blocks_batch / vmm_unmap_blocks_batch |
요청 슬롯마다 토큰 수에 맞춰 KEY·VALUE 페이지를 늘리고 반환 |
| 블록 | — | KV 캐시를 매핑하는 논리적인 페이지 단위. 일반적으로 HW 페이지를 하나 이상 묶음. 크기는 연산마다 block_size로 정함 |
| HW 페이지 | — | 블록을 디바이스 메모리에 배치하는 주소 변환 단위. 런타임이 관리 |
요청 슬롯은 요청 하나의 KV 주소 행 번호이며, vLLM slot_mapping의 슬롯(토큰 위치)과 다릅니다.
엔지니어링 샘플
현재 디바이스(엔지니어링 샘플)에서는 다음 조건을 따릅니다.
- 풀과 매핑에서는 블록 하나가 토큰 하나입니다(
block_size=1). 주소 예약과vmm_init_blocks에서는 요청 슬롯 행 하나를 블록 하나(block_size= 요청당 최대 토큰 수)로 둡니다. HW 페이지는 요청마다 할당되며, HW 페이지 하나에 여러 토큰이 들어갑니다. - 요청의 블록은 늘어나기만 합니다. 요청이 살아 있는 동안 매핑은 블록을 늘리기만 하며, 해제는 요청(슬롯) 단위로 한 번에 이루어집니다.
- prefix caching은 multi-turn 이어 쓰기로 동작합니다. 새 요청이 이전 요청의 KV 전체로 시작하면(같은
대화의 다음 턴처럼) 그 KV를 이어 씁니다. vLLM 예제는 prefix caching을 끈 설정(
--no-enable-prefix-caching)을 기준으로 합니다. vLLM KV 캐시를 보십시오.
KV 주소 텐서는 일반 lpu 텐서처럼 커널에 넘기지만, 매핑되지 않은 위치는 실제 데이터가
아닙니다. 런타임 진입점의 동작은
런타임 메모리 모델 §3.7을
보십시오.
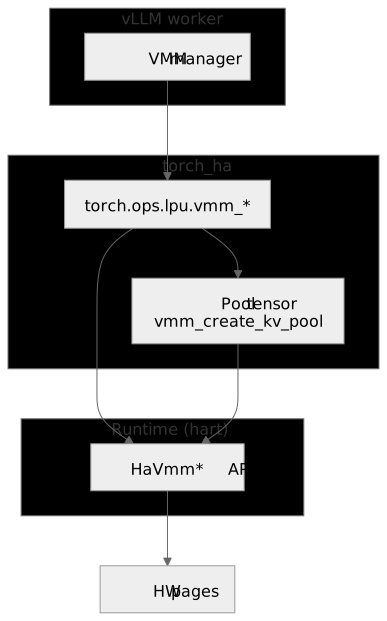
torch 연산과 HaVmm* 런타임이 HW 페이지를 관리합니다
5.2 풀 만들기¶
1 2 3 4 5 | |
- 형상 — dim 0은
{KEY, VALUE}입니다. 블록 하나가 토큰 하나이므로block_size는1이고, dim 1은 풀의 토큰 예산입니다. 토큰 하나는L * H * D * itemsize바이트입니다. - 초기화 — 반환 전에
zero_()로 0을 채웁니다. 채우는 경로는 디바이스 시맨틱 §2.7과 같습니다. - 정렬 —
page_size(기본 4096)는 풀 기준 주소의 정렬입니다. 기본값을 그대로 두십시오. - 수명 — 풀 메모리는 풀 텐서가 소유합니다. 마지막 참조가 사라지면 물리 메모리가 해제되며, 따로 해제하는 연산은 없습니다.
vmm_create_kv_pool에는 fake 커널이 있어 FakeTensorMode에서도 디바이스를 건드리지 않습니다.
연산별 상세는 VMM API §풀을 보십시오.
5.3 초기화 순서¶
vmm_init_blocks가 풀을 받으므로 풀을 먼저 만들고 마지막에 vmm_init_blocks에 넘깁니다.
1 2 3 4 5 6 7 8 9 10 11 12 | |
- KEY·VALUE 주소는 요청 슬롯 행마다 블록 하나(
block_size = T토큰)로 예약합니다. vmm_init_blocks의max_num_blocks_per_row × block_size(1 × T)는 요청당 최대 토큰 수입니다. 이 값은 주소 예약의 토큰 깊이와 같아야 합니다.- 풀은 한 요청의 KEY·VALUE 페이지를 담을 만큼 커야 합니다. 부족하면
vmm_init_blocks가 실패합니다. vmm_init_blocks의 첫 인자(num_rows)는 요청 슬롯 수로, vLLM의max_num_seqs와 비슷한 개념입니다(요청 슬롯은 현재 최대 1024개).
해제할 때는 모든 요청을 unmap한 뒤 풀 텐서를 놓고 vmm_deinit을 호출하십시오. KV 주소 텐서는 물리 메모리를 갖지 않으므로 따로 해제할 필요가 없습니다.
1 2 | |
5.4 스텝마다 매핑¶
스케줄러 스텝마다 끝난 요청을 먼저 unmap하고, 자란 요청을 map합니다. unmap을 먼저 해야 같은 스텝에서 비운 슬롯을 다시 쓸 수 있습니다. 두 호출 모두 배치 형태를 쓰십시오.
vmm_map_blocks_batch는 CUDA의 cuMemMap과 달리 물리 위치를 호출자가 지정하지 않습니다. 요청 슬롯마다
늘어난 토큰 수를 넘기면 풀에서 HW 페이지가 배정됩니다.
| 인자 | 의미 |
|---|---|
vmm_tensors |
[k, v] |
row_indices |
요청 슬롯 행 0–1023. 필수 |
cached_blocks_per_req |
이미 매핑된 토큰 수 |
new_block_ids |
값은 쓰이지 않음. 비우거나 길이를 sum(new_blocks_per_req)로 |
new_blocks_per_req |
새 토큰 수 |
pool |
vmm_create_kv_pool로 만든 풀 텐서를 넘김. 현재 엔지니어링 샘플에서는 페이지가 vmm_init_blocks에 등록한 풀에서 할당됨 |
block_size |
1 |
unmap blocks_per_req |
요청에 매핑된 토큰 수 전체. 요청 단위로 한 번에 반환 |
cached_block_ids와 unmap의 block_ids는 값이 쓰이지 않습니다. []를 넘기거나, 넘길 때는
길이를 개수의 합과 맞추십시오.
1 2 3 4 5 6 7 | |
map은 토큰 수의 차이로 필요한 KEY·VALUE 페이지만 추가합니다. 매 스텝 정확한 "이미 매핑된 토큰 수"를 넘기십시오.
5.5 vLLM에서의 흐름¶
vLLM 통합의 워커는 KV 캐시를 아래 순서로 관리합니다.
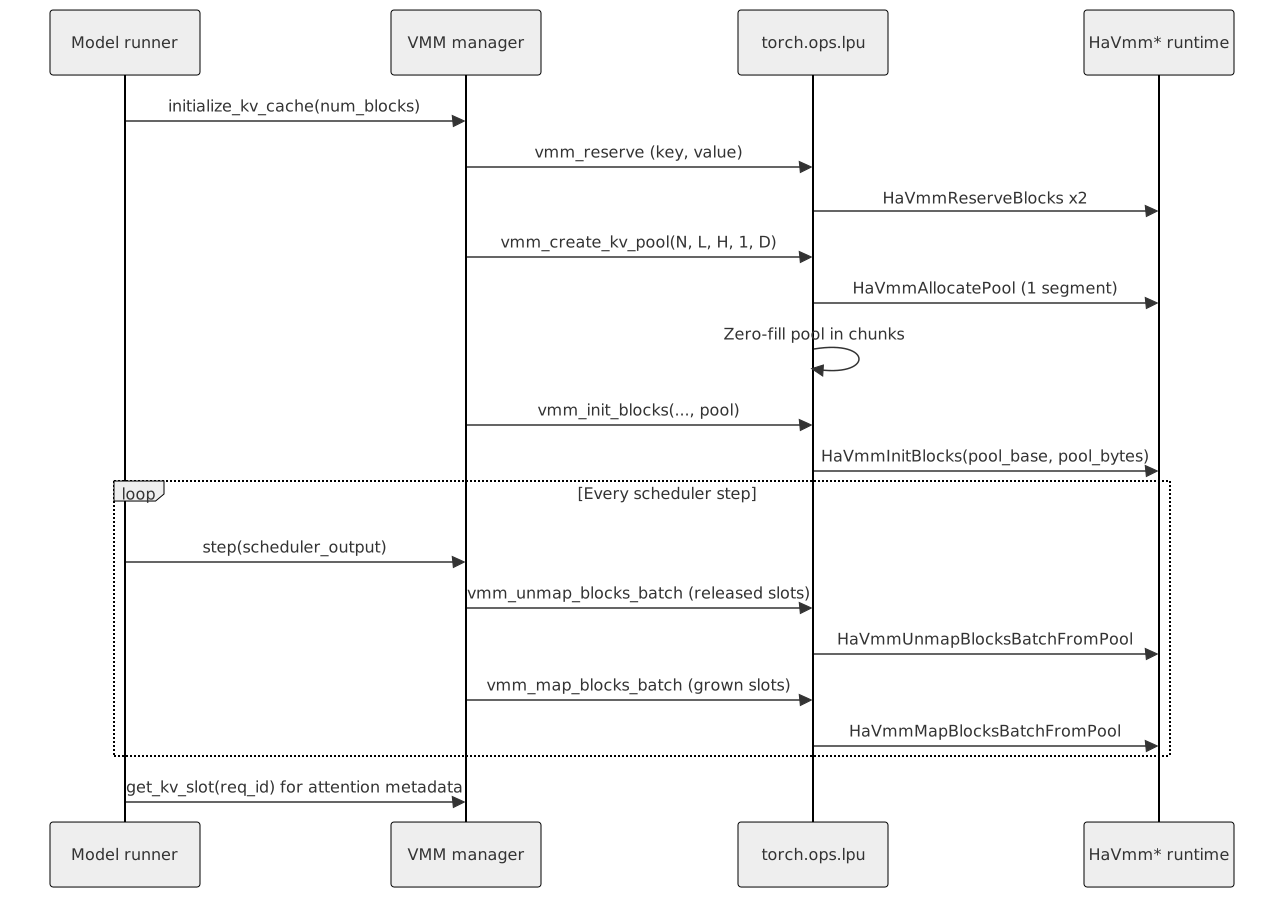
vLLM 워커의 VMM 호출 순서
- KV 캐시 초기화 (한 번) —
vmm_reserve(1024, L, H, max_model_len, D, "key"/"value",
   dtype)
를 두 번 호출하고,vmm_create_kv_pool(num_blocks, L, H, 1, D, dtype=..., device=...)로 풀을 만든 뒤,vmm_init_blocks(max_num_seqs, 1, L, H, max_model_len, D, bits, pool)로 등록합니다.num_blocks는 풀의 총 토큰 예산입니다. - 스텝마다 — 해제된 슬롯을
vmm_unmap_blocks_batch한 번으로 반환합니다. 토큰 수가 늘어난 슬롯을vmm_map_blocks_batch로 넘깁니다. 새 페이지가 필요 없는 슬롯은 연산이 건너뜁니다. 요청이 끝나거나 선점되면 슬롯을 반환합니다. prefix caching을 켜면 끝난 요청의 슬롯을 다음 턴을 위해 남겨 둘 수 있습니다. - attention 메타데이터 — 워커가 요청마다 하드웨어 요청 슬롯 번호를 커널에 넘깁니다. 커널은 vLLM 블록 테이블 대신 이 번호로 KV를 찾습니다.
플러그인은 vLLM의 --block-size를 1로 고정하므로 vLLM의 num_blocks가 곧 풀의 토큰 수입니다. 주소 예약과 vmm_init_blocks에 block_size로 넘기는 max_model_len은 이 설정과 별개입니다.
서빙 인자는 vLLM 인자를 보십시오.
5.6 규칙¶
풀 텐서를 먼저 놓지 마십시오
풀의 물리 메모리는 풀 텐서의 마지막 참조와 함께 해제됩니다. 매핑된 요청이 남아 있는 상태에서 풀을 놓으면 HW 페이지가 해제된 메모리를 가리킵니다. 모든 요청을 unmap할 때까지 풀 텐서를 유지하십시오.
페이지를 읽는 커널이 끝난 뒤 unmap하십시오
unmap이 실행 중인 커널을 기다린다고 가정하지 마십시오. 반환할 슬롯을 읽는 커널이
끝났는지(예: torch.accelerator.synchronize()) 확인한 뒤 unmap하고, 그 슬롯을 다른 요청에
넘기십시오.
torch.compile: vmm_reserve는 fake 커널이 없습니다
vmm_reserve를 FakeTensorMode나 torch.compile 트레이싱 안에서 호출하면 실제
디바이스 호출이 일어납니다. 예약과 풀 생성은 컴파일된 영역 밖, 엔진 초기화 단계에서
하십시오.
- 현재 디바이스 — 모든 VMM 연산은 호출 스레드의 현재 디바이스로 라우팅됩니다. 풀은 그 디바이스의 텐서여야 합니다.
- 재초기화 —
vmm_init_blocks를 다시 호출하면 기존 상태가 먼저 정리됩니다. - 에러 — 런타임 호출이 실패하면
RuntimeError가<연산>: <런타임 진입점> failed: err=<코드>형태로 발생합니다.
다음 단계¶
- CUDA에서 이전하기 — CUDA 코드와의 차이 목록
- VMM API — 연산별 시그니처와 예제
- 분산 — 멀티 디바이스 실행