Torch Backend for HyperAccel¶
Torch Backend for HyperAccel(torch_ha)은 PyTorch의 외부 백엔드 메커니즘(PrivateUse1)을
통해 HyperAccel LPU를 PyTorch의 네이티브 디바이스로 등록합니다. 텐서를 "lpu"로 옮기면
연산이 LPU 백엔드로 디스패치되고, torch.distributed에 LPU용 백엔드가 추가됩니다. 모델
계산은 torch.compile(backend="legato")로 컴파일해 디바이스에서 실행합니다.
스택 내 위치¶
torch_ha는 사용자가 가장 먼저 만나는 계층입니다. PyTorch와 런타임 사이에
있으며, vllm_hyperaccel이 이 위에 구현되어 있습니다.
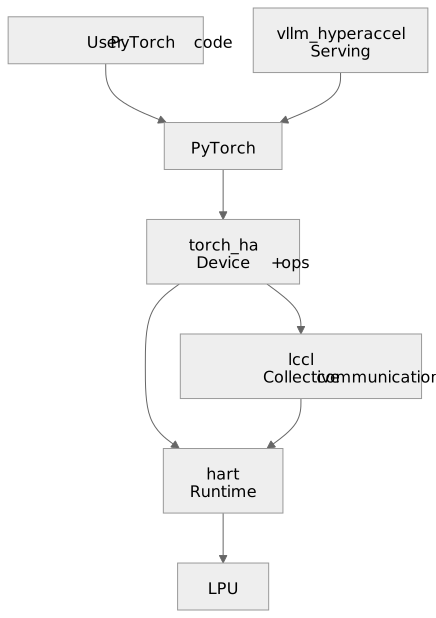
torch_ha는 PyTorch와 런타임(hart)·집합 통신(lccl) 사이에 있습니다.
한눈에 보기¶
| 패키지 | torch_ha |
| 버전 | 0.0.6 |
| 디바이스 문자열 | "lpu". torch.device("lpu"), torch.accelerator |
| PyTorch | 2.10.0 |
| 분산 백엔드 | "lccl" |
| 등록 시점 | import torch 시 자동 |
| Python | 3.10 |
| 상태 | Beta |
문서¶
 프로그래밍 가이드
디바이스 동작 방식, 어떤 연산이 있는지, LPU에서 도는 PyTorch 코드를 쓰는 법.
디바이스 시맨틱 · 연산 · 분산 · Paged KV 캐시 · CUDA에서 이전하기 · 문제 해결

 릴리즈 노트
버전별 변경 사항, 폐기 예정 항목, 알려진 문제.
첫 프로그램¶
import torch_ha는 필요 없습니다. PyTorch가 import torch 과정에서 백엔드를
발견해 등록합니다.
다음 코드는 bfloat16 텐서 두 개를 LPU로 옮겨 더합니다.
1 2 3 4 5 6 7 8 | |
모델 계산에는 torch.compile을 사용합니다. 같은 덧셈을 컴파일하면 다음과 같습니다.
첫 호출에는 컴파일 시간이 포함됩니다.
1 2 3 4 5 6 7 8 | |
컴파일 경로는 Torch Legato 입문에서 자세히 다룹니다.
모델을 옮기기 전에 확인할 것¶
torch_ha는 beta이며, 현재는 PyTorch 연산의 일부만 LPU에서 구동할 수 있습니다. 모델 구동은
torch.compile(backend="legato")로 컴파일해 실행하십시오.
eager 모드에서 디바이스로 계산되는 연산은 네 가지입니다
dtype=bfloat16의 add, sub, mul, mm이며, 미리 빌드된 shape과 연속(contiguous) 피연산자에서 실행됩니다.
그 밖의 계산 연산을 eager로 호출하면 NotImplementedError가 발생합니다. 단, multinomial과 exponential_은 에러 없이 고정값을 반환합니다(연산 지원 목록).
그 밖에 torch_ha가 지원하는 eager 연산은 텐서를 옮기고 view·slice를 만드는 연산입니다.
목록은 연산 지원 목록에 있습니다.
torch.compile 경로의 커버리지는 legato resolver가 결정합니다
모델 계산은 torch.compile(backend="legato") 경로로 지원합니다. 컴파일되는 연산의
조건은 legato resolver에 따릅니다.
Compile PyTorch Model with Legato를
참조하십시오.
컴파일되지 않는 연산은 eager로 실행되므로, 위 네 가지가 아닌 계산 연산은 실행 중에 실패합니다. dry run을 통과해도 실행까지 보장되지는 않습니다. 확인 방법은 연산 §3.3을 보십시오.
설치¶
torch_ha는 단독으로 설치하지 않습니다. 컴파일러, 런타임, 프로파일러, 서빙 통합과
함께 HyperAccel SDK wheel 하나로 배포됩니다.
SDK 설치 가이드를 참고하십시오.
호환성¶
이 문서는 torch_ha 0.0.6 기준입니다.
| 검증된 버전 | |
|---|---|
| PyTorch | 2.10.0 |
| Python | 3.10 |
Runtime (hart) |
0.0.6 |
집합 통신 (lccl) |
0.0.6 |
PyTorch 버전은 최소값이 아니라 정확한 값입니다
PyTorch의 비공개 디스패치 표면에 등록하는 백엔드는 빌드 대상 버전에 묶입니다. 지원 매트릭스를 보십시오.