1. 개요¶
이 가이드는 PyTorch 코드를 HyperAccel LPU에서 실행하는 방법을 다룹니다. torch_ha는 LPU를
PyTorch의 lpu 디바이스로 추가합니다. 텐서와 모델은 .to("lpu")로 옮기고, 모델 계산은
torch.compile(backend="legato")로 컴파일합니다. vllm_hyperaccel로 서빙한다면 torch_ha를
직접 다룰 일은 없습니다.
이 장을 먼저 읽으십시오. 이후 장들은 여기서 정의한 개념을 전제로 합니다.
Contents¶
| Section | Objective |
|---|---|
| 1.1 백엔드가 하는 일 | torch_ha가 PyTorch에 등록하는 디바이스, 할당자, 커널, 분산 백엔드 |
| 1.2 설계 배경 | PrivateUse1 등록과 import 시점 자동 로드가 낳는 결과 |
| 1.3 핵심 개념 | 이후 장에서 반복해서 쓰는 용어 정리 |
| 1.4 첫 프로그램 | 최소 예제와 처음부터 알아 둘 세 가지 규칙 |
| 1.5 백엔드의 내부 구성 | 에러 메시지를 읽는 데 필요한 구성 요소와 책임 |
1.1 백엔드가 하는 일¶
torch_ha는 LPU를 PyTorch 디바이스로 만듭니다. 구체적으로 다음을 등록합니다.
- 디바이스 —
"lpu".torch.device("lpu")와torch.accelerator로 다룹니다. - 할당자와 디바이스 가드 — 텐서가 LPU 메모리에 존재하고
.to("lpu")가 동작하게 합니다. - eager 연산 — 텐서 이동, view·slice 같은 연산과 실험적 eager 계산(
bfloat16의add,sub,mul,mm)을 지원합니다. 모델 계산에는torch.compile(backend="legato")를 씁니다. 연산 §3.1을 보십시오. - 분산 백엔드 —
torch.distributed용"lccl". - Autocast — LPU에서는 사용하지 않습니다.
torch.autocast("lpu")안의 연산은NotImplementedError를 내므로 명시적으로 캐스팅하십시오. 디바이스 시맨틱 §Autocast를 보십시오.
모두 import torch 때 등록됩니다. torch_ha를 import하거나 초기화 함수를 호출할 필요는 없습니다.
1.2 설계 배경¶
마주치게 될 대부분의 일을 설명하는 두 가지입니다.
백엔드는 PyTorch의 PrivateUse1 디바이스로 등록됩니다. PyTorch는 외부 백엔드용으로 이름을
바꿀 수 있는 디바이스 타입 PrivateUse1을 하나 제공합니다. torch_ha가 그것을 차지해 이름을 lpu로
바꾸므로, .to("lpu")와 torch.accelerator를 기본 디바이스처럼 쓸 수 있습니다.
동시에 **한 프로세스에 외부 백엔드를 하나만 로드할 수 있다**는 뜻이기도 합니다.
PrivateUse1 슬롯은 프로세스마다 하나입니다.
등록은 import torch 중에 일어납니다. PyTorch는 import될 때 설치된 디바이스 백엔드를
불러오고, torch_ha는 이때 LPU를 등록합니다. 등록에 실패해도 PyTorch의 나머지 기능은 쓸 수
있도록 import torch는 성공하고, 에러는 로그에만 남습니다. 이때는 lpu 디바이스가 없으므로
처음 .to("lpu")를 호출할 때 알 수 없는 디바이스라며 실패합니다.
1.3 핵심 개념¶
| 개념 | 의미 |
|---|---|
lpu 디바이스 |
등록된 디바이스 문자열. torch.device("lpu"), tensor.to("lpu"). |
PrivateUse1 |
외부 백엔드를 위한 PyTorch 디스패치 키. 로드 시 lpu로 이름이 바뀝니다. |
| 등록된 연산 | eager 경로에 LPU 구현이 등록된 ATen 연산. 등록되었다고 디바이스에서 실행되지는 않습니다. 연산 지원 목록 참조. |
| 백엔드 메타 | 텐서 스토리지가 디바이스 메모리에 어떻게 배치되어 있는지를 기술하는 정보. |
| 텐서 kind | 가중치가 사용하는 디바이스 레이아웃. nn.Linear와 nn.Embedding 가중치는 lpu로 이동할 때 자동으로 태깅됩니다. |
lccl 백엔드 |
LPU 집합 통신을 위한 torch.distributed 백엔드 이름. |
등록 실패는 조용합니다
백엔드 등록에 실패해도 import torch는 성공하며 실패는 로그에만 남습니다.
증상은 나중에 torch.device("lpu")가 알 수 없는 디바이스라며 실패하는 것입니다.
실제 원인은 import 시점의 로그에 있습니다.
문제 해결을 보십시오.
1.4 첫 프로그램¶
1 2 3 4 5 6 7 8 9 10 11 | |
eager 모드에서 디바이스로 계산되는 연산은 bfloat16의 add, sub, mul, mm이며, 피연산자는 연속(contiguous)이어야 합니다.
모델 계산은 연산 §3.1을 보십시오.
반복해서 만나게 될 세 가지를 미리 짚어 둡니다.
- 난수 텐서는 CPU에서 만든 뒤 옮기십시오.
torch.randn(..., device="lpu")대신torch.randn(...).to("lpu")를 쓰십시오. - 값을 읽으면 디바이스를 기다립니다.
print(x),.cpu(),.item()은 앞선 작업이 끝나기를 기다린 뒤 값을 호스트로 복사합니다. - 랭크마다 디바이스를 한 번 선택하십시오. 한 프로세스가 여러 디바이스를 볼 수 있고,
디바이스는 스레드 단위로 바인딩됩니다. 시작할 때
torch.accelerator.set_device_index()로 디바이스를 고르고, 이후에는 인덱스 없이 할당하십시오. 분산 §4.2를 보십시오.
1.5 백엔드의 내부 구성¶
사용하는 데는 필요하지 않지만 에러를 읽을 때 필요합니다.
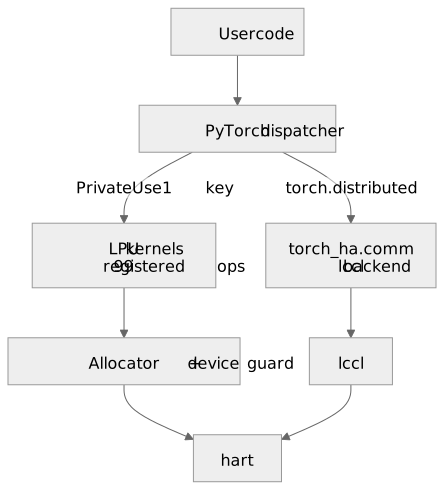
디스패처 아래의 torch_ha 구성 요소 — 연산 경로와 분산 경로 모두 hart에서 만납니다
| 구성 요소 | 책임 |
|---|---|
| 할당자 | LPU 텐서를 hart에서 얻은 디바이스 메모리로 뒷받침합니다. |
| 디바이스 가드 | 현재 디바이스가 PyTorch의 디바이스 컨텍스트 규칙을 따르게 합니다. |
| 연산 등록 | 디스패처에 필수적인 연산은 직접 구현하고, 계산 연산은 코드 생성으로 등록합니다. |
| 백엔드 메타 | view 연산을 거쳐도 디바이스 레이아웃이 유지되게 합니다. reshape되거나 stride된 텐서도 자신이 어떻게 저장되어 있는지 압니다. |
torch_ha.comm |
lccl을 torch.distributed 백엔드로 등록합니다. |
여기서 따라오는 실무적 결론입니다.
- 에러 메시지의 백엔드 이름은 대개
lpu입니다. 일부 저수준 메시지에 나오는PrivateUse1도 같은 것입니다. - 레이아웃 에러는 스토리지를 재해석하는 연산(
view,as_strided,reshape)에서 드러나지만, 실제 원인은 그 텐서가 어떻게 만들어졌는지인 경우가 많습니다.
다음 단계¶
- 디바이스 시맨틱 — 디바이스 동작 방식
- 연산 — 무엇이 등록되어 있고, 없으면 어떻게 되는가
- 분산 — 디바이스를 여러 개 쓰기
- Paged KV 캐시 — 가상 메모리로 KV 캐시 블록을 매핑하기
- CUDA에서 이전하기 — CUDA 코드와의 차이
- 에러 처리 — 예외와 로그를 읽는 법
- 문제 해결 — 증상별 색인