1. 개요
HyperAccel Runtime(hart)은 디바이스, 메모리, 커널 실행을 제어하는 API입니다.
torch_ha(PyTorch)와 vllm_hyperaccel(모델 서빙)은 내부에서 이 API를 호출하므로, 이를 통해 사용한다면
런타임 API를 직접 다룰 일은 거의 없습니다. 본 문서는 상위 프레임워크 없이 런타임 수준에서 시스템을
연동하는 개발자를 위한 프로그래밍 가이드입니다.
Contents
| Section | Objective |
|---|---|
| 1.1 런타임 API의 역할 | 런타임 API가 필요한 이유와 드라이버 API와의 구분 |
| 1.2 설계 배경 | API 설계를 결정한 6가지 원칙과 지켜야 할 점 |
| 1.3 핵심 개념 | 가이드 전반에서 공통으로 사용하는 용어와 정의 |
| 1.4 기본 사용 예제 | 메모리 할당, 복사, 해제의 기본 코드 흐름 |
실행 모델, 메모리 모델, 스트림과 이벤트, 멀티 디바이스는 순서대로 읽는 것을 전제로 작성했습니다. 에러 처리와 문제 해결은 필요할 때 찾아볼 수 있도록 구성했습니다. 가중치를 디바이스 레이아웃으로 변환하는 방법은 가중치 변환에서 따로 다룹니다. 디바이스 핸들 기반의 드라이버 API는 별도의 드라이버 API 가이드에서 다룹니다.
1.1 런타임 API의 역할
LPU에서 연산을 실행하려면 커널 바이너리를 디바이스에 로드하고, 피연산자를 디바이스 메모리에 배치한 뒤 실행해야 합니다. 런타임 API는 이 과정을 디바이스, 메모리, 실행, 동기화 API로 제공하며, 여러 스레드와 여러 디바이스에서 쓸 때 필요한 디바이스 선택과 주소 라우팅을 대신 처리합니다. 따라서 애플리케이션은 디바이스 핸들을 직접 관리하지 않고 연산 흐름에 집중할 수 있습니다. 디바이스를 핸들로 직접 지정해야 하는 경우에는 드라이버 API를 사용합니다.
아래 그림은 런타임 API를 사용하는 소프트웨어의 구성입니다. 각 스레드는 사용할 디바이스만 지정하고 디바이스 인자 없이 API를 호출하며, 디바이스별 제어와 포인터 라우팅은 런타임 API가 맡습니다.
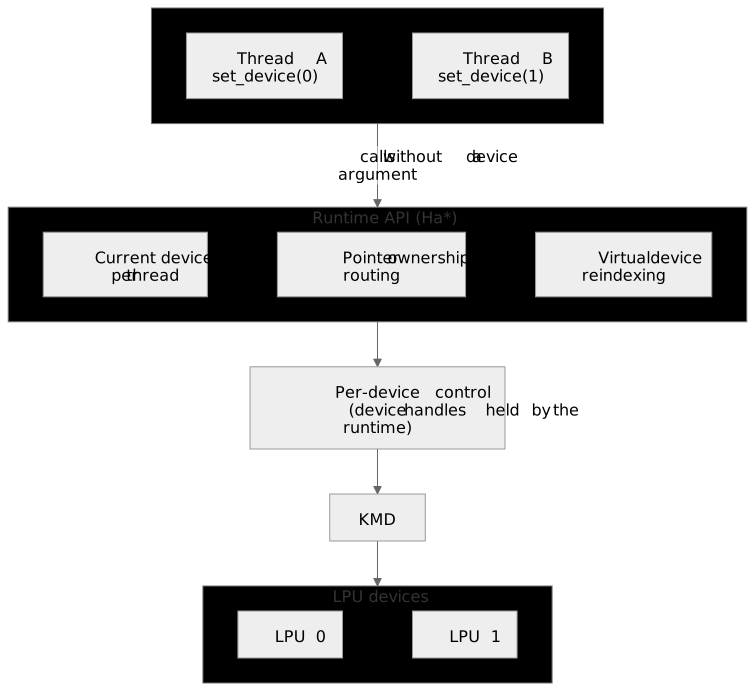
런타임 API를 사용하는 소프트웨어의 계층 구조
1.2 설계 배경
API의 형태를 결정한 여섯 가지 설계 원칙과, 각 원칙에 따라 코드를 작성할 때 지켜야 할 점입니다.
- CUDA 런타임 호환성 — 함수 이름과 의미를 CUDA 런타임에 맞췄습니다.
cuda접두사 대신Ha접두사를 쓰며(C++:HaMemAlloc, Python:mem_alloc), 같은 이름의 함수는 같은 역할을 합니다. CUDA와 동작이 다른 지점은 해당 장에서 따로 명시합니다. - 스레드 단위 디바이스 선택 — 대상 디바이스는 호출 인자가 아니라 스레드마다 지정한 현재
디바이스로 정해집니다. 그래서 할당, 실행 같은 API에는 디바이스 인자가 없습니다. 각 스레드는 런타임
API를 쓰기 전에
set_device()(C++:HaSetDevice())를 먼저 호출해야 하며, 지정하지 않으면HaDeviceInvalidArgument를 반환합니다. - 메모리 풀링 —
mem_free()(C++:HaMemFree())로 해제한 메모리는 런타임 풀에 남아 이후 할당에 재사용될 수 있습니다. 따라서 해제 직후에도 디바이스의 여유 메모리가 늘지 않을 수 있습니다. 다른 프로세스나 큰 할당을 위해 메모리를 돌려줘야 하면device_mem_trim()(C++:HaDeviceMemTrim())을 호출하십시오. - 포인터 기반 디바이스 라우팅 —
mem_free(),mem_cpy()(C++:HaMemCpy())처럼 디바이스 포인터를 받는 함수는 그 포인터가 속한 디바이스에서 동작합니다. 다른 스레드가 할당한 메모리도 현재 디바이스를 바꾸지 않고 해제하거나 복사할 수 있습니다. 다만 호출 스레드에는 현재 디바이스가 지정되어 있어야 합니다. - 동기·비동기 함수 쌍 — 메모리 할당·해제·복사(N-D 복사 포함)와 커널 실행은 동기 함수와
비동기 함수(이름 끝
_async, C++:Async)를 함께 제공합니다. 비동기 함수는 작업을 스트림에 넣고 바로 반환하므로, 작업이 끝날 때까지 넘긴 호스트 버퍼를 해제하거나 수정하지 마십시오. 파일 로드(mem_load_file_async())는 비동기 함수만, 3D 할당(mem_alloc_3d())은 동기 함수만 있습니다. 자세한 동작은 실행 모델의 동기·비동기 디스패치를 참고하십시오. - 출력 인자 기반 에러 모델 — C++ API는 예외를 던지지 않고 모든 함수가
HaError를 반환하며, 할당된 주소나 조회한 값은 호출하는 쪽이 넘긴 변수에 채워 돌려줍니다. 예를 들어HaGetDeviceCount(&count)는 디바이스 수를count에 씁니다. 반환값이HaSuccess인지 매번 확인하십시오. Python API는 같은 코드 이름을 담은RuntimeError를 발생시킵니다. 자세한 내용은 에러 처리를 참고하십시오.
1.3 핵심 개념
본 가이드의 이어지는 내용에서 공통으로 사용되는 핵심 용어와 그 정의를 정리합니다.
| 개념 | 의미 |
|---|---|
| 런타임(Runtime) | 별도의 초기화 과정이 필요하지 않습니다. 프로세스에서 처음 런타임 API를 호출할 때 자동으로 초기화되며, 프로세스당 하나로 모든 스레드가 공유합니다. 첫 호출에서 생길 수 있는 오류는 에러 처리의 프로세스의 첫 호출들을 참고하십시오. |
| 디바이스(Device) | LPU 1대를 의미하며, [0, HaGetDeviceCount()) 범위의 가상 디바이스 ID로 식별합니다. 하드웨어가 사용하는 물리 ID와는 다릅니다(멀티 디바이스 프로그래밍의 가상 디바이스 ID 참고). |
| 현재 디바이스 | 스레드가 작업할 디바이스입니다. set_device()(C++: HaSetDevice())로 스레드마다 지정하며, 이후 그 스레드의 할당이나 커널 실행은 이 디바이스에서 이루어집니다. |
| 디바이스 포인터 | HaDevicePtr 타입의 64비트 디바이스 주소입니다. 호스트에서 직접 역참조(Dereference)하는 것은 허용되지 않습니다. |
| 텐서 레이아웃(Tensor Layout) | 텐서의 shape, stride, 데이터 타입, 메모리 스코프를 담은 HaLayout 객체입니다. 데이터 포인터를 담지 않으므로, 같은 모양의 여러 버퍼를 복사할 때 레이아웃 하나를 재사용할 수 있습니다(메모리 모델의 텐서 레이아웃 참고). |
| 스트림(Stream) | 비동기 작업을 넣는 큐입니다. 같은 스트림에 넣은 작업은 넣은 순서대로 실행되며, 서로 다른 스트림 사이의 실행 순서는 보장되지 않습니다. |
| 이벤트(Event) | 스트림에 기록하는 표식입니다. 기록하기 전에 넣은 작업이 끝났는지 확인하거나 기다릴 때, 또는 다른 스트림이 그 지점까지 기다리게 할 때 사용합니다. |
| 커널(Kernel) | Legato로 작성해 컴파일한, 디바이스에서 실행되는 프로그램입니다. 커널에 넘길 인자는 인자 목록(HaLaunchArgs)에 담아 전달합니다. 실행 방법은 실행 모델을 참고하십시오. |
1.4 기본 사용 예제
디바이스를 찾아 메모리를 할당하고, 데이터를 옮긴 뒤 해제하는 기본 예제입니다.
1 2 3 4 5 6 7 8 9 10 11 | |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | |
C++: 전송 방향은 direction 인자가 결정합니다
HaMemCpy()는 양방향 모두 HaDevicePtr 타입을 인자로
받습니다. 호스트 포인터 또한 동일한 타입으로 캐스팅되어 전달되며, 어느 쪽이 호스트이고 어느 쪽이
디바이스인지는 타입 정보가 아니라 direction 인자가 결정합니다. 따라서 전송 방향을 잘못 지정하더라도
컴파일 타임 타입 오류로는 포착되지 않습니다.