3. 메모리 모델
디바이스 메모리에는 호스트(CPU) 가상 메모리에는 없는 아키텍처 제약이 있습니다. 본 장은 디바이스 메모리를 다룰 때 런타임 관점에서 직면하는 다음 세 가지 핵심 제약을 다룹니다.
- 역참조 불가 — 디바이스 포인터 주소를 획득하더라도 호스트 스레드에서 직접 역참조(Dereferencing)할 수 없습니다.
- 해제 후 풀에 보관 — 해제한 메모리는 바로 반환되지 않고 런타임 풀에 남아 재사용될 수 있습니다. 실제 사용량은
메모리 통계로 확인하고, 풀에 남은 빈 세그먼트는
device_mem_trim()으로 디바이스에 반환할 수 있습니다. - 커널별 레이아웃 종속성 — 동일한 물리적 바이트 시퀀스라 하더라도 타겟 커널의 메모리 액세스 패턴 및 레이아웃 규격에 따라 정렬(Alignment) 및 배치(Layout) 구조가 달라져야 합니다.
런타임은 디바이스 메모리 할당 비용을 줄이기 위해 메모리를 세그먼트 단위로 확보해 풀에 보관하고, 할당 요청을 이 풀에서 처리합니다. 해제한 메모리는 풀로 돌아가 재사용되며, 풀에 보관된 빈 세그먼트는 반환 API를 호출해야 디바이스의 여유 메모리로 돌아갑니다.
실제 할당량과 풀이 보관 중인 양은 디바이스 메모리 통계로 확인합니다. 자세한 내용은 사용량 확인과 반환을 참고하십시오. 호스트 버퍼도 같은 방식의 호스트 메모리 관리자로 할당할 수 있습니다.
Contents
| Section | Objective |
|---|---|
| 3.1 디바이스 포인터와 호스트 포인터 (Device & Host Pointers) | 디바이스 주소와 호스트 주소의 차이, 역참조 제약 |
| 3.2 할당과 해제 (Allocation & Deallocation) | 디바이스 메모리(풀 캐싱, 통계와 반환), 호스트 메모리 |
| 3.3 텐서 레이아웃 (Tensor Layout) | 하드웨어 아키텍처 규격에 따른 메모리 스트라이드 및 정렬(Alignment) 메커니즘 |
| 3.4 데이터 전송 (Transfer) | 동기 및 비동기 전송 모델, 다차원 텐서 전송 |
| 3.5 파일 직접 로드 (Direct File Load) | 파일 디스크립터로부터 디바이스 메모리로의 직접 적재 |
| 3.6 디바이스 메모리 덤프 (Device Memory Dump) | 디바이스 내부 메모리 덤프를 활용한 레이아웃 배치 검증 |
| 3.7 가상 메모리 및 HW 페이지 관리 (Virtual Memory & HW Pages) | KV 캐시용 가상 메모리: 호출 순서와 규칙 |
3.1 디바이스 포인터와 호스트 포인터 (Device & Host Pointers)
런타임 API가 다루는 주소는 두 가지입니다.
- 디바이스 포인터: 디바이스 메모리의 주소로, 64비트 정수 타입인
HaDevicePtr(Python:int)로 표현됩니다.mem_alloc()(C++:HaMemAlloc())이 돌려주는 주소이며, 호스트 포인터가 아니므로 호스트에서 역참조하면 미정의 동작이 발생합니다. 내용을 읽거나 쓰려면 전송 함수로 복사해야 합니다. - 호스트 포인터: 호스트 메모리의 주소로, 호스트에서 바로 읽고 쓸 수 있습니다. 일반적으로 할당한 메모리와
host_mem_alloc()(C++:HaHostMemAlloc())으로 할당한 메모리 모두 전송에 쓸 수 있습니다.
전송 함수의 주소 인자
데이터 전송 함수인 mem_cpy()(C++: HaMemCpy())는 C++에서 소스와 목적지를 모두
HaDevicePtr로 받으므로, 호스트 포인터도 이 타입으로 캐스팅해 넘깁니다(Python은 bytes 같은 버퍼 객체나 int
주소를 넘김). 따라서 인자 타입만으로는 주소가 호스트 쪽인지 디바이스 쪽인지 구분할 수 없으므로, 전송 방향은
direction 인자로 지정합니다. 다차원 전송(HaMemCpyNd)은
레이아웃의 scope로 지정합니다.
3.2 할당과 해제 (Allocation & Deallocation)
디바이스 메모리는 현재 디바이스의 풀에서, 호스트 메모리는 프로세스 단위 관리자에서 할당합니다.
디바이스 메모리 (Device Memory)
할당 (Allocation)
1 2 3 4 5 | |
1 2 3 4 5 6 | |
메모리 할당 API는 크게 선형 버퍼를 위한 mem_alloc()과 다차원 텐서
형태를 다루는 mem_alloc_3d()(C++: HaMemAlloc3D())로
구분됩니다. 두 API 모두 HyperAccel LPU의 다중 DRAM 채널(Multi-channel DRAM)
아키텍처를 활용하기 위한 할당 전략을 is_interleaved 인자로 선택할 수
있습니다.
- 연속 할당 (Contiguous Allocation) — 데이터를 단일 채널에 집중시켜 순차적 접근에 최적화합니다. 다만 나머지 채널에서도 같은 크기의 영역을 점유하므로, 점유하는 디바이스 메모리는 요청 크기에 채널 수를 곱한 만큼입니다.
- 인터리브 할당 (Interleaved Allocation) — 데이터를 여러 채널에 분산 배치하여 커널이 전체 채널의 집계 대역폭(Aggregate Bandwidth)을 최대한 활용할 수 있도록 합니다.
어떤 전략을 쓸지는 버퍼를 사용하는 커널이 피연산자에 접근하는 방식에 따라 정해집니다. 모든 할당을 인터리브로 두기보다는, 커널이 기대하는 메모리 배치에 맞춰 명시적으로 지정해야 합니다.
참고: HaShape 필드 의미
3D 텐서 할당 시 사용하는 HaShape의 각 필드는 다음과 같은 의미를
지닙니다.
w(Width) — 연속 방향으로 뻗는 폭을 의미합니다.h(Height) — 채널·블록 단위로 분할되는 높이를 의미합니다.c(Channel) — 이름과 달리 현재 버전에서는 반드시1이어야 하며, 그 이상의 값은 지원되지 않습니다.
단, 인터리브 모드와 청크 단위 정렬 제약으로 인해 패딩이 삽입되므로 실제 물리적
크기는 w * h * c 바이트를 상회할 수 있습니다.
해제 (Deallocation)
1 | |
1 | |
해제한 메모리: 해제한 메모리는 풀로 돌아가 다음 할당에 자동으로 재사용됩니다. 해제로 세그먼트가 통째로
비었을 때, 다른 할당이 남아 있고 풀에 보관 중인 빈 메모리가 할당 중인 양의 절반을 넘으면 그 세그먼트를 바로
반환합니다. 그 밖의 경우, 특히 모든 할당을 해제한 경우에는 다음 할당을 위해 보관합니다. 보관 중인 빈 세그먼트를
비워야 할 때는 메모리 통계의 releasable_bytes로 추가로 확보할 수 있는 용량을 확인한 뒤
device_mem_trim()(C++: HaDeviceMemTrim())을 호출하십시오. 통계 항목과 반환 방법은 사용량 확인과 반환을 참고하십시오.
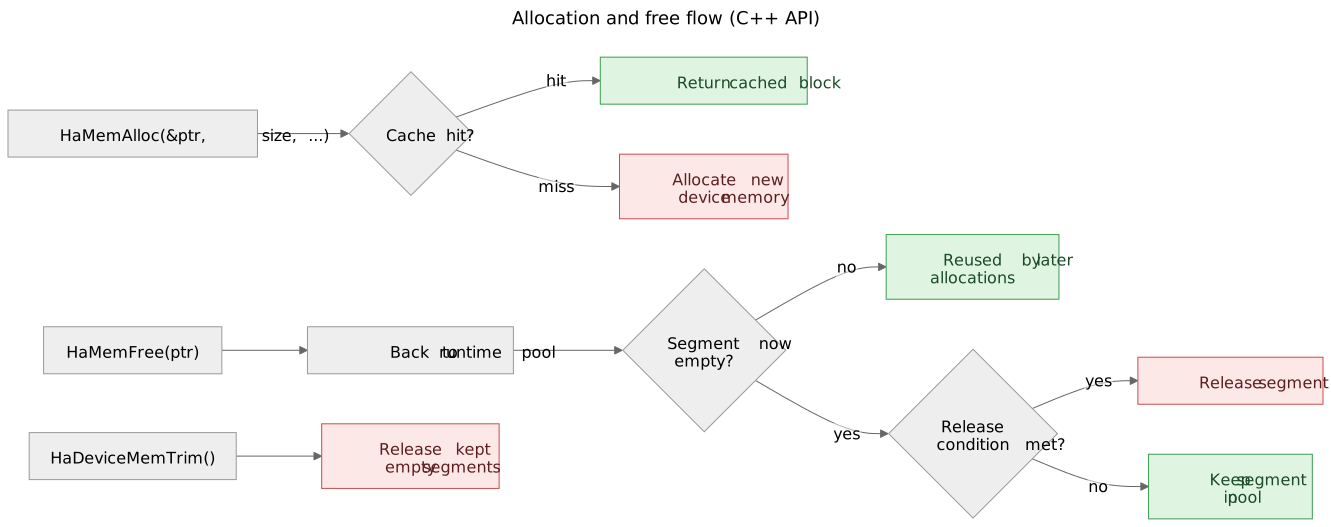
런타임 캐싱 메커니즘을 통한 메모리 재사용 흐름도 (C++ API 기준. Python: mem_alloc(), mem_free(), device_mem_trim())
성능 최적화 가이드: 프로덕션 환경의 인퍼런스 서빙 루프에서는 오버헤드 방지를 위해 동적 할당을 지양해야 합니다. 워크로드에 필요한 대규모 버퍼는 초기화 단계(Initialization Phase)에서 미리 할당(Pre-allocation)한 뒤, 서빙 루프 내에서 재사용하는 방식을 권장합니다.
실행 중에 1 MiB를 넘는 버퍼를 반복해서 할당해야 한다면 HA_HUGE_POOL_THRESHOLD_SIZE_MB를
설정할 수 있습니다. 설정하면 이 크기 이하의 할당을 같은 크기로 확보한 영역에서 나눠 쓰므로, 디바이스 메모리를
확보하는 횟수가 줄어듭니다. 설정한 크기를 넘는 할당은 기존처럼 따로 확보합니다. 사용이 끝난 영역은
device_mem_trim()으로 반환할 수 있지만, 영역 안에 할당이 하나라도 남아 있으면 반환되지 않습니다.
사용량 확인과 반환 (Memory Statistics & Trim)
캐싱 때문에 시스템이 보는 사용량과 실제 할당량이 다르므로, 현재 디바이스의 메모리 상태는 통계로 확인합니다.
device_mem_get_stats()(C++: HaDeviceMemGetStats())는 런타임 메모리 카운터(할당 중인 바이트, 그 최대값 등)와 함께, 디바이스 전체의 여유 DRAM(free_bytes, 다른 프로세스의 사용분
반영)을 돌려줍니다. 최대값은 device_mem_reset_peak_stats()(C++: HaDeviceMemResetPeakStats())로 현재 값부터 다시 셉니다.
런타임이 보관 중인 빈 세그먼트를 반환해 디바이스의 여유 메모리를 늘리려면 device_mem_trim()(C++: HaDeviceMemTrim())을
호출합니다. 할당이 남아 있는 세그먼트는 반환하지 않습니다. mem_free_async()(C++: HaMemFreeAsync())로 해제한 메모리는
그 스트림을 동기화한 뒤에야 반환 대상이 되므로, 트림 전에 스트림을 먼저 동기화하십시오.
1 2 3 4 | |
1 2 3 4 5 | |
사용량을 모니터링할 때 주로 보는 필드는 다음과 같습니다. 바이트 값은 모든 DRAM 채널을 합한 값입니다.
| 필드 | 의미 |
|---|---|
total_bytes / free_bytes |
디바이스의 DRAM 용량과 현재 여유 DRAM. 다른 프로세스의 사용분이 반영됨 |
allocated_bytes |
프로그램이 할당해 아직 해제하지 않은 블록의 크기. 풀의 할당 단위로 올림한 크기이므로 요청한 크기의 합보다 클 수 있음 |
reserved_bytes |
런타임 풀이 확보해 보관 중인 크기. 해제한 메모리도 포함되므로 allocated_bytes 이상 |
releasable_bytes |
할당된 블록이 없는 세그먼트의 크기. device_mem_trim()으로 추가로 확보할 수 있는 용량 |
peak_* |
마지막으로 최대값을 초기화한 뒤의 최대값 |
특정 구간의 최대 사용량을 재려면 구간 시작 전에 최대값을 초기화하고, 구간이 끝난 뒤 peak_allocated_bytes나
peak_reserved_bytes를 읽습니다. HA_DEVICE_MEM_STATS_PRINT=1을 설정하면 통계를 조회할 때마다 표준 에러에도
출력합니다. 전체 필드 정의는 HaDeviceMemStats를 참고하십시오.
호스트 메모리 (Host Memory)
런타임은 디바이스 메모리와 별개로 프로세스 단위의 호스트 메모리 관리자를 제공합니다. 전송에 쓸 호스트 버퍼를 이 관리자에서 할당할 수 있으며, 현재 디바이스를 지정하지 않아도 사용할 수 있습니다.
할당 (Allocation)
1 | |
1 2 | |
host_mem_alloc()(C++: HaHostMemAlloc())은 64바이트 정렬 호스트 메모리를 할당하며,
내용은 초기화되지 않습니다. 프로세스가 OS에서 확보하는 호스트 메모리의 상한은
HA_HOST_MEM_MAX_BYTES로 정합니다. 한도를 넘는
할당은 빈 영역을 OS에 돌려준 뒤에도 부족하면 HaHostMemLimitExceeded(Python: RuntimeError)로 실패합니다.
해제 (Deallocation)
1 2 3 | |
1 2 3 | |
해제한 메모리: host_mem_free()(C++: HaHostMemFree())로 해제한 메모리는 풀로
돌아가 다음 할당에 자동으로 재사용됩니다. 비동기 복사에 넘긴 버퍼는 복사가 끝날 때까지 해제하지 마십시오.
메모리를 비워야 할 때는 통계를 확인한 뒤 host_mem_trim()을 호출하십시오. 통계 항목과 반환 방법은
사용량 확인과 반환을 참고하십시오.
사용량 확인과 반환 (Memory Statistics & Trim)
host_mem_get_stats()(C++: HaHostMemGetStats())는 프로세스 전체의 호스트 메모리
통계를 돌려줍니다. 최대값은 host_mem_reset_peak_stats()(C++: HaHostMemResetPeakStats())로
현재 값부터 다시 셉니다. 풀에 보관 중인 해제된 메모리는 host_mem_trim()(C++: HaHostMemTrim())으로
OS에 반환합니다. 할당이 남아 있는 영역은 반환하지 않습니다.
1 2 3 | |
1 2 3 4 | |
| 필드 | 의미 |
|---|---|
allocated_bytes |
할당해 아직 해제하지 않은 메모리의 크기. 요청한 크기 그대로 셈 |
reserved_bytes |
OS에서 확보해 보관 중인 크기. 해제한 메모리도 포함되므로 allocated_bytes 이상 |
peak_* |
마지막으로 최대값을 초기화한 뒤의 최대값 |
alloc_count / free_count |
지금까지의 할당·해제 횟수 |
HA_HOST_MEM_STATS_PRINT=1을 설정하면 통계를 조회할 때마다 표준 에러에도 출력합니다. 전체 필드 정의는
HaHostMemStats를 참고하십시오.
3.3 텐서 레이아웃 (Tensor Layout)
LPU에서 실행할 커널이 읽을 텐서는 해당 커널이 요구하는 레이아웃에 맞춰 디바이스 메모리에 저장해야 합니다.
런타임은 현재 선택된 디바이스의 채널 수, DRAM 워드 크기, 채널 오프셋 등의 하드웨어 정보를 조회하여, 최적의 텐서 레이아웃을 계산합니다.
단, 개발자는 필요한 텐서 종류(HaTensorKind)와 논리적 차원(dims)을
명시적으로 지정해야 합니다(아래 표 참고).
다음 예제는 디바이스를 선택한 뒤 레이아웃을
계산하고, 반환된 shape와 strides를 확인합니다.
1 2 3 4 5 6 7 8 9 10 | |
1 2 3 4 5 6 7 | |
반환된 layout.shape와 layout.strides는 디바이스 메모리에 실제로 저장되는 배치를 나타내므로, 입력한 dims와
차원 수나 크기가 다를 수 있습니다. 예를 들어 위 예제의 SingleChannel은 맨 앞에 채널 차원을 붙여 [34, 128]을
(채널 수, 34, 128)로 돌려줍니다. 다차원 전송(mem_cpy_nd())에는
입력 dims가 아니라 반환된 레이아웃을 그대로 넘기십시오.
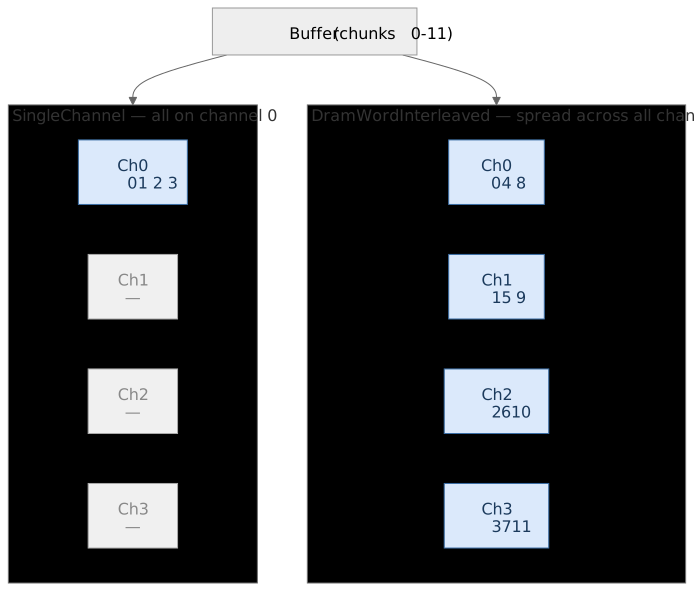
SingleChannel과 DramWordInterleaved의 채널별 데이터 배치
HaTensorKind |
요구되는 랭크(Rank) | dims 인자의 정의 및 제약 조건 |
|---|---|---|
DramWordInterleaved |
>= 1 |
전체 원소 수에만 의존하며, 연속적인 논리적 셰이프(Shape)를 그대로 전달 |
SinglePassInterleaved |
>= 1 |
위와 동일하나, 채널별 정렬 제약이 더욱 엄격하게 적용됨 |
SingleChannel |
>= 1 |
전체 데이터가 채널 0에 연속적으로 집중 배치됨 |
RowInterleaved |
>= 2 |
최하위 차원이 행 너비 W, 나머지 상위 차원들의 곱이 총 행 수로 해석됨 |
MaxRowsInterleaved |
>= 2 |
RowInterleaved와 유사하나 청크(Chunk) 얼라인먼트 규칙이 상이함 |
MPUTensor |
>= 2 |
최하위 차원이 head_dim, 직전 차원이 block_size, 나머지 상위 차원들의 곱이 총 블록 수로 해석됨 |
KvCacheKey / KvCacheValue |
정확히 5 | [num_blocks, num_layers, num_kv_heads, block_size, head_dim] 구조를 엄수 |
위와 같은 텐서별 셰이프 제약 외에도, 레이아웃을 정의하고 API를 호출할 때 반드시 준수해야 하는 하드웨어 제약 및 실행 규칙은 다음과 같습니다.
- 인터리브드(Interleaved) 종류 정렬: 모든 인터리브드 종류는 채널당 청크
크기가 DRAM 워드 크기의 정수 배수로 정확히 부합해야 합니다(예: Bertha Cloud
아키텍처는 64 바이트, Bertha Edge 아키텍처는 32 바이트). 특히
SinglePassInterleaved는 전체 비트 수가num_channels * dram_word_size * 8의 배수여야 한다는 더 엄격한 제약이 따릅니다. 조건을 위반한 레이아웃 정의는 묵시적 패딩(Silent Padding) 없이 즉시 반려(Reject)됩니다. - MPUTensor 및 KV 캐시 제약:
head_dim크기가channels_per_token * elements_per_word값으로 정확히 나누어떨어져야 하며, 미충족 시HaMemoryInvalidArgument에러가 반환됩니다. - API 호출 순서: 플랫폼 상수는 타겟 디바이스의 하드웨어 스펙을 기반으로
산출되므로,
build_device_tensor_layout()(C++:HaBuildDeviceTensorLayout()) 호출 전 반드시set_device()(C++:HaSetDevice())가 선행되어야 합니다. 미선행 시HaDeviceInvalidArgument또는HaDeviceNotInitialized를 반환합니다.
1 2 3 | |
1 2 3 4 | |
실제 텐서 없이, 더미 차원으로 호출하여 디바이스의 하드웨어 상수만 조회할 수도 있습니다(아래 예제 참고).
1 2 3 4 5 | |
1 2 3 4 5 6 7 | |
build_device_tensor_layout()(C++: HaBuildDeviceTensorLayout())은 dims 외에
선택적으로 strides 인자도 받습니다.
Stride 파라미터 호환성 안내:
현재 버전(0.0.6)에서 strides 매개변수는 표준 연속 논리 스트라이드만 수용하며, 그
외의 커스텀 스트라이드 패턴은 HaNotSupported를 반환합니다. 향후 런타임
업데이트에 대비하여 API 인터페이스 호환성을 유지하기 위해 미리 공개된 항목이므로,
표준 row-major 연속 배치의 경우 nullptr을 전달하십시오.
3.4 데이터 전송 (Transfer)
동기 전송 (Synchronous Transfer)
1 2 3 4 | |
1 2 3 4 | |
위 예시는 HaMemCpyDirection으로 복사 방향을 지정해 호스트와 디바이스 간 또는
디바이스 간 데이터를 동기식으로 전송하는 API 호출 패턴입니다.
특징:
- 동기 실행 (Sync):
mem_cpy()는 요청된 데이터 전송 작업이 하드웨어 레벨에서 완전히 종료될 때까지 호출자 스레드의 제어권을 반환하지 않습니다. 즉, 함수가 리턴되는 순간 소스(Source) 메모리를 재사용하거나 목적지(Destination) 데이터를 즉시 읽어들이는 것이 안전합니다. - 파라미터 구성: 목적지 포인터(
dst), 소스 포인터(src), 전송할 바이트 크기(size), 그리고 복사 방향(HaMemCpyDirection)을 인자로 받습니다.
전송 방향 및 디바이스 간 제약 사항:
- 기본 전송 (H2D / D2H): 호스트와 디바이스 간의 기본적인 데이터 업로드 및 다운로드를 지원합니다.
- 디바이스 간 복사 (D2D): 동일한 디바이스 내부에서의 디바이스 간
복사(
DeviceToDevice) 역시 런타임과 하드웨어에 의해 네이티브로 지원됩니다. - 크로스 디바이스(Inter-Device) 전송 제한: 서로 다른 디바이스 간의 전송은
디바이스가 피어 전송을 지원하는지에 따라 달라집니다. 지원하지 않는
디바이스 사이에서 크로스 전송을 시도할 경우, 별도의 소프트웨어 우회 경로(Software
Fallback)를 통한 저속 전송으로 자동 대체되지 않고 즉시
HaMemCpyNotSupported에러를 반환합니다. 멀티 디바이스 환경에서의 상세한 토폴로지 및 전송 제약 조건은 멀티 디바이스 프로그래밍 문서를 참조하십시오.
비동기 전송 (Asynchronous Transfer)
1 2 | |
1 2 | |
위 예시는 대상 실행 스트림(Stream)을 통해 데이터 복사 커맨드를 비동기로 인큐잉(Enqueued)하고, 스트림 동기화 API를 통해 전송 완료를 보장받는 기본적인 API 호출 패턴을 보여줍니다. 이는 하드웨어 연산과 데이터 전송을 오버랩(Overlap)하여 성능을 극대화하기 위한 비동기식(Asynchronous) 데이터 전송 인터페이스입니다.
특징:
- 비동기 실행 (Async): 데이터 복사 커맨드는 지정된 실행 스트림에 인큐잉되며, 함수 호출이 즉시 반환됩니다. 이 시점에는 실제 하드웨어가 전송 동작을 아직 개시하지 않았을 수 있습니다.
- 버퍼 수명 및 동기화 제약:
stream_synchronize()나 이벤트로 복사 완료를 확인하기 전에는 호스트 측 소스 버퍼를 수정하거나 대상 버퍼를 읽지 마십시오. 그 전에 접근하면 복사와 데이터 레이스가 일어나 결과를 보장할 수 없습니다.
다차원 텐서 전송 (Multi-dimensional Transfer)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | |
위 예시는 소스와 목적지 간의 N차원 뷰(View) 규격을 기반으로 다차원 텐서 데이터를 전송하는 기본적인 API 호출 패턴을 보여줍니다. 이는 두 개의 N차원 뷰 간의 복잡한 메모리 레이아웃 전송을 처리하기 위한 다차원 전송 인터페이스입니다.
특징:
- 인자 구조 (
Pointer, Layout쌍): 개별 전송 인자는 포인터와 레이아웃의 쌍으로 구성되며, 두 개의 N차원 뷰 간 데이터 전송을 유연하게 처리합니다. 위 예제는 높이(h), 너비(w)의 2차원 뷰를 다루지만, 랭크(Rank)는 이 값에 고정되지 않고 확장 가능합니다. - 포인터와 레이아웃의 분리: 포인터와 레이아웃 규격이 의도적으로 분리되어 설계된 이유는, 단일 KV 캐시 블록 레이아웃 정의 등을 재사용하여 여러 개의 독립적인 버퍼 인스턴스 전송에 공통으로 적용하기 위함입니다. 따라서 버퍼가 바뀔 때마다 레이아웃 객체를 매번 재생성할 필요가 없습니다.
레이아웃 검증 규칙 및 에러 코드:
| 검증 항목 | 위반 시 발생하는 예외 및 동작 |
|---|---|
| 두 레이아웃 간 랭크(Rank) 및 형상(Shape) 일치 여부 | HaMemoryInvalidArgument(본 API는 자동 브로드캐스트를 지원하지 않음) |
차원 수 유효성 검증(1 <= ndim <= HA_MAX_NDIM) |
HaMemoryInvalidArgument |
| 스트라이드(Stride) 단위는 바이트가 아닌 데이터 타입(dtype)의 원소 수 기준 | 에러 없이 잘못된 메모리 주소를 참조 |
| 포인터 유효성 검증(Null 포인터 전달 시) | HaMemoryInvalidAddress |
추가 전송 동작 및 최적화:
- 전송 방향 자동 추론: 데이터 전송 방향은 양쪽 레이아웃 객체에 내장된
scope필드로부터 자동 추론되므로 별도의 인자로 요구되지 않습니다. 소스와 타겟 양쪽 모두 호스트 영역을 가리키는 경우에도 유효하며, 이 경우 디바이스 전송 없이 호스트 메모리 내에서 복사가 처리됩니다. - 자동 정규화 및 평탄화 최적화: 런타임은 이 두 뷰를 내부적으로 정규화한 뒤, 각 뷰 안에서 메모리상 끊김없이 이어지는(스트라이드가 맞아떨어지는) 인접 차원들을 자동으로 하나로 합칩니다. 그 결과 논리적으로는 다차원 구조라 하더라도 실제 메모리 배치가 연속적이라면 단 한 번의 전송(Single-pass Transfer)으로 처리되며, 호출자가 전송 효율을 위해 미리 뷰를 평탄화(Flattening)할 필요가 없습니다.
3.5 파일 직접 로드 (Direct File Load)
1 | |
1 | |
열린 파일 디스크립터(File Descriptor)로부터 파일 시스템 입출력(I/O) 스트림을 통해 디바이스 메모리로 직접 적재(Direct Loading)를 수행하므로, 호스트 시스템 메모리를 경유하는 불필요한 메모리 복사 오버헤드가 발생하지 않습니다. 대규모 모델 가중치(Weights)의 초기 로딩 페이즈에서 권장되는 최적화 경로입니다.
3.6 디바이스 메모리 덤프 (Device Memory Dump)
dump_for_each_channel()(C++: HaMemDumpForEachChannel())은 할당의 원시 바이트를
디인터리브 없이 DRAM 채널별로 하나씩 읽어 옵니다.
1 | |
1 2 | |
레이아웃이 의도한 위치에 놓였는지 확인하는 디버깅 도구입니다. 전체 크기를 동기로 전송하므로 데이터 경로로 사용해서는 안 됩니다.
3.7 가상 메모리 및 HW 페이지 관리 (Virtual Memory & HW Pages)
이 절의 호출 순서와 값은 현재 디바이스(엔지니어링 샘플) 기준입니다.
KV 캐시는 HW 페이지로 주소를 변환합니다. VMM API가 HW 페이지를 관리하므로, 주소 예약·풀 할당·요청별 페이지 관리를 VMM API로 처리하십시오.
개념 (Concepts)
| 용어 | 의미 |
|---|---|
| 블록 (Block) | KV 캐시를 매핑하는 논리적인 페이지 단위. 일반적으로 HW 페이지를 하나 이상 묶습니다. 엔지니어링 샘플에서는 풀과 매핑의 블록 하나가 토큰 하나입니다(map·unmap의 block_size 1). num_attn_layers × num_kv_heads × head_dim × 요소 크기 바이트 |
| 풀 (Pool) | 모든 KV를 담는 물리 메모리. 앞 절반은 K, 뒤 절반은 V. 항상 연속된 세그먼트(HaVmmBlockSegment) 하나이며, 해제 대상은 raw_ptr |
| KV 주소 | 커널이 쓰는 주소. 변환 사용 비트(58), K/V 비트(57), 요청 슬롯(비트 56:47, 0–1023)으로 이루어지며 예약이 아닙니다 |
| HW 페이지 | 블록을 배치하는 주소 변환 단위. 엔지니어링 샘플에서는 채널당 4 KiB |
| 요청 페이지 | 요청 슬롯마다 HW 페이지 단위로 할당되는 KEY·VALUE 페이지. HW 페이지 하나는 (레이어, 헤드)마다 4 KiB × 채널 수를 담습니다. 요청이 살아 있는 동안 토큰 수에 맞춰 늘어나기만 하고, 요청 단위로 반환됩니다 |
모든 호출은 호출 스레드의 현재 디바이스(HaSetDevice()로 선택, id 0–7)로 라우팅됩니다. 주소 값은
디바이스 선택에 쓰이지 않습니다.
호출 순서 (Call Order)
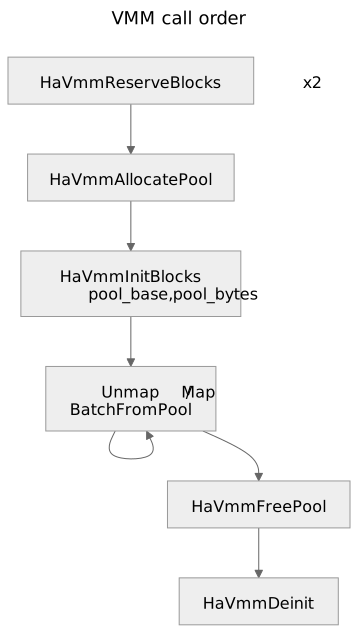
풀을 먼저 만들고, 그 풀로 HW 페이지를 초기화합니다
아래 예제는 L개 레이어, H개 KV 헤드, head_dim D, bf16(16비트) KV 캐시를 가정합니다.
R은 요청 슬롯 수, T는 요청당 최대 토큰 수, N은 풀이 K와 V 각각에 담는 토큰 수입니다.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | |
KV 주소는 예약이 아니므로 해제할 것이 없습니다. 인자별 의미는
VMM API에 있습니다. max_num_blocks_per_row × block_size(1 × T)는
요청당 최대 토큰 수이며, 풀은 요청 하나의 KEY·VALUE 페이지를 담을 만큼 커야 합니다.
규칙 (Rules)
페이지가 매핑된 풀을 해제하지 마십시오
HaVmmFreePool()은 매핑 여부를 검사하지 않습니다.
요청 페이지가 남은 채로 풀을 해제하면 해제된 메모리가 다음 할당에 재사용되는데, HW 페이지는 여전히
그 주소를 가리킵니다. 모든 요청을 언매핑한 뒤 해제하십시오. 해제 대상은 pa_start가 아니라
raw_ptr이며, HaVmmFreePool()이 이를 처리합니다.
이전 스텝의 커널이 끝난 뒤에 매핑을 바꾸십시오
매핑과 언매핑은 실행 중인 커널을 기다리지 않습니다. 이전 스텝의 커널이 끝난 것을 확인한 뒤 다음 스텝의 매핑을 바꾸십시오.
매 스텝 정확한 토큰 수를 넘기십시오
매핑은 cached_blocks_per_req(이미 매핑된 토큰 수)와 새 토큰 수의 차이만큼 페이지를 늘립니다.
언매핑에는 요청에 매핑된 토큰 수 전체를 넘기십시오. 요청 단위로 한 번에 해제됩니다.
HaVmmInitBlocks를 다시 부르면 기존 상태가 사라집니다
재호출하면 기존 상태를 해체한 뒤 다시 초기화합니다.
PyTorch 연산과 런타임 진입점의 대응 (PyTorch Ops and Runtime Entry Points)
PyTorch의 torch.ops.lpu.vmm_* 연산은 인자를 검증한 뒤 아래 런타임 진입점으로 내려갑니다. 연산
목록과 시그니처는 PyTorch VMM 연산에 있습니다.
| PyTorch 연산 | 런타임 진입점 |
|---|---|
vmm_create_kv_pool |
HaVmmAllocatePool |
vmm_reserve |
HaVmmReserveBlocks |
vmm_init_blocks |
HaVmmInitBlocks |
vmm_map_blocks, vmm_map_blocks_batch |
HaVmmMapBlocksBatchFromPool |
vmm_unmap_blocks, vmm_unmap_blocks_batch |
HaVmmUnmapBlocksBatchFromPool |
vmm_deinit |
HaVmmDeinit |
vLLM 플러그인이 이 연산들을 호출하는 순서는 Paged KV 캐시: vLLM에서의 흐름에 있습니다.