6. PyTorch 프로파일러 연동
haprof는 프로그램 프로세스 전체를 대상으로 별도의 트레이스 파일을 생성합니다. 이미
torch.profiler를 활용 중인 팀의 경우 기존 PyTorch 트레이스 외에 별도의 프로파일러 출력이 추가되는
셈이므로, CPU 연산은 PyTorch 트레이스에서, 디바이스 활동은 haprof 트레이스에서 각각 확인한 뒤 눈으로
대조해야 하는 번거로움이 있습니다.
Kineto 플러그인은 이 문제를 해결합니다. LPU 활동을 PyTorch 프로파일러 자신의 트레이스 내부에
통합하므로, aten::matmul 연산과 그 연산이 유발한 디바이스 커널이 흐름 화살표로 바로 이어집니다. 본
장에서는 플러그인의 동작 원리, 등록 및 사용법, 트레이스에 들어가는 내용, 그리고 haprof와의 선택
기준을 다룹니다.
Contents
| Section | Objective |
|---|---|
| 6.1 Kineto 연동 구조 | 벤더 트레이서가 연동되는 아키텍처 위치 |
| 6.2 플러그인 등록 | 플러그인을 로드하는 한 줄의 코드 |
| 6.3 프로파일링 실행 | PrivateUse1 활동 지정 방법 |
| 6.4 수집 항목 및 흐름 화살표 | 활동 종류 및 흐름 화살표 연동 |
| 6.5 디바이스 타임라인 수집 | 디바이스 레코드 활성화 조건 및 진단 메시지 |
| 6.6 레코드 변환 시점 | 레코드가 트레이스로 변환되는 시점과 유실 조건 |
6.7 haprof와 Kineto 플러그인 선택 기준 |
환경별 프로파일러 선택 가이드 |
6.1 Kineto 연동 구조
libkineto는 PyTorch의 프로파일링 전용 하드웨어 추상화 계층입니다. torch.profiler가 출력하는
Chrome 트레이스 파일은 단 하나이지만, 그 내부의 디바이스별 이벤트는 하드웨어 벤더별 트레이서가 각각
채웁니다. 이 트레이서들이 플러그인 형태로 장착되는 지점이 바로 IActivityProfiler ABI입니다.
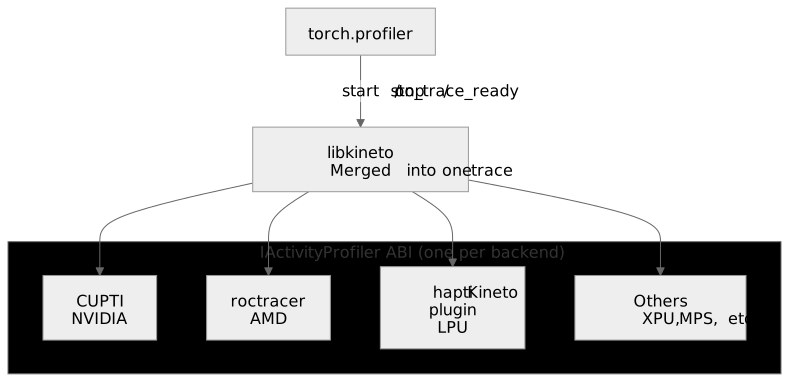
libkineto에 연동되는 벤더별 트레이서 구조
즉, LPU 백엔드는 NVIDIA 및 AMD가 사용하는 것과 동일한 표준 연동 통로를 통해 연결됩니다. 별도의 전용
뷰어나 포맷이 필요 없으며, torch.profiler의 UI, 출력 포맷, Python 진입점을 그대로 활용할 수 있습니다.
플러그인의 유일한 역할은 IActivityProfiler 인터페이스를 구현하여 Kineto가 다른 백엔드와 마찬가지로
hapti를 구동할 수 있도록 중개하는 것입니다.
6.2 플러그인 등록
1 2 3 | |
hapti.kineto.register() 함수는 플러그인을 Kineto에
IActivityProfiler로 등록합니다. 프로세스 내에서 한 번만 호출하면 되며, 여러 번 호출해도 안전합니다.
런타임 호출을 볼 수 있는 이유
플러그인은 프로세스에 이미 로드된 hart 런타임과 같은 인스턴스를 사용하므로, 애플리케이션이 호출하는
모든 Ha* 런타임 API를 관측합니다. 런타임 호출이 보이지 않는 경우
문제 해결을 참고하십시오.
플러그인 빌드가 누락된 경우 등록 시점에 즉시 에러가 발생합니다.
1 | |
6.3 프로파일링 실행
LPU 이벤트 데이터를 수집하려면 ProfilerActivity.PrivateUse1을 활동 목록에 반드시 포함해야
합니다.
1 2 3 4 5 6 7 8 9 | |
PrivateUse1은 PyTorch가 외부 가속기 백엔드를 위해 예약해 둔 디스패치 키(Dispatch Key)이며, LPU가
등록되는 슬롯입니다. Torch 디바이스 시맨틱에서
다루는 lpu 디바이스와 동일한 키를 공유합니다.
6.4 수집 항목 및 흐름 화살표
Kineto가 요청한 활동 종류에 따라 플러그인은 다음과 같은 데이터를 트레이스에 포함시킵니다.
| Kineto 활동 종류 | LPU 매핑 내용 |
|---|---|
PRIVATEUSE1_RUNTIME |
런타임 API 호출 내역(Ha*). 메모리 할당 호출의 경우 할당된 바이트 수 포함 |
PRIVATEUSE1_DRIVER |
런타임 하위 계층 호출 내역 |
CONCURRENT_KERNEL |
디바이스 커널 실행 구간(디바이스 타임라인 수집 참고) |
GPU_MEMCPY |
호스트↔디바이스 간 메모리 전송 및 대역폭 정보 |
EXTERNAL_CORRELATION |
CPU 연산과 LPU 활동 간의 연결 관계 |
GPU_MEMCPY라는 명칭은 Kineto 프레임워크의 공통 용어입니다. LPU 환경에서도 동일한 명칭을 그대로
사용하는데, 새로운 이벤트 종류를 임의로 만들면 torch.profiler UI에서 정상적으로 표시되지 않기
때문입니다.
Kineto 경로에서 수집되지 않는 항목
- 하드웨어 카운터 — 커널 타임라인만 수집되며 카운터는 포함되지 않습니다. 하드웨어 카운터 분석이
필요한 경우
haprof --device-trace를 사용하십시오. hapti주석 —hapti.annotate()로 지정한 구간은 이 경로에 기록되지 않습니다. PyTorch 트레이스 내에서 구간 이름을 지정하려면 PyTorch 표준인torch.profiler.record_function()을 사용해야 합니다 (PyTorch 프로파일러 연동 참고).
흐름 화살표(Flow Arrows)
CPU 연산과 LPU 활동은 두 단계에 걸쳐 연결됩니다. PyTorch가 CPU 연산마다 외부 식별자(external ID)를
부여하면, 플러그인은 해당 연산 내부에서 발생한 런타임 호출의 correlation id를 그 외부 식별자에
매핑합니다. 커널과 메모리 전송은 자신을 유발한 런타임 호출과 동일한 correlation id를 공유하므로,
torch.profiler가 CPU 연산 구간에서 디바이스 활동 구간으로 이어지는 흐름 화살표를 자동으로 그립니다.
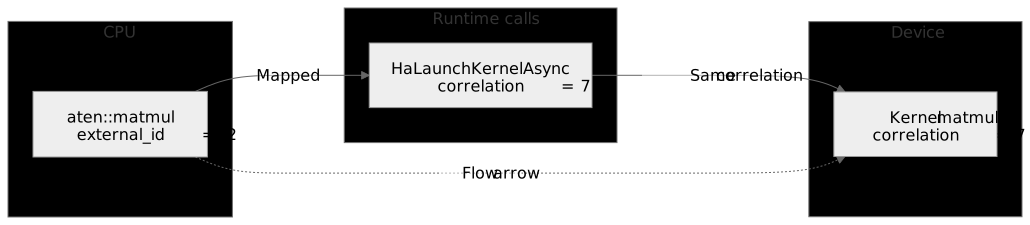
external ID → correlation id → 디바이스 레코드로 이어지는 연결 구조
이 구조를 통해 특정 디바이스 커널이 어떤 Python/PyTorch 코드에서 호출되었는지 역으로 추적할 수 있습니다.
6.5 디바이스 타임라인 수집
플러그인은 CONCURRENT_KERNEL 활동이 요청된 경우, 프로파일링 구간(profile() 블록)이 시작될 때
디바이스 레코드 링을 설정하고 구간이 끝날 때 레코드를 수거한 뒤 해제합니다. GPU_MEMCPY 활동이 함께
요청된 경우 메모리 전송 레코드 수집도 함께 활성화됩니다.
| 관련 환경 변수 | 효과 및 설명 |
|---|---|
HAPTI_KINETO_DEVICE_TRACE |
값이 0, false, off인 경우 디바이스 타임라인 수집 비활성화(기본값: 활성화) |
HAPTI_KINETO_DEVICE |
대상 디바이스를 명시적으로 지정. 미지정 시 프로파일링 구간을 연 스레드의 현재 디바이스 사용 |
디바이스 타임라인을 생성할 수 없거나 수집 과정에 문제가 발생한 경우, 플러그인은 torch.profiler 경고를
통해 알립니다.
| 경고 메시지 | 의미 및 조치 |
|---|---|
No LPU device (S6) time in this trace: ... |
디바이스 프로파일링 설정 실패. 원인이 메시지 뒷부분에 함께 표시됨 |
LPU device (S6) time was captured from device N by default |
구간 시작 시점에 바인딩된 디바이스가 없어 기본 디바이스(N번)를 사용함. 디바이스 사용을 시작한 뒤 구간을 열거나 HAPTI_KINETO_DEVICE로 직접 지정 권장 |
... LPU device activities fell outside the capture window and were dropped |
구간이 끝나는 시점에 아직 완료되지 않은 커널은 수집에서 제외됨 |
... bytes of device records were overwritten before the reader drained them |
레코드 링 오버런으로 디바이스 타임라인 일부가 비어 있음 |
N LPU devices in one session; only device M gets a named trace row |
한 구간에서 여러 디바이스를 썼으며, 가장 낮은 번호의 디바이스만 이름 있는 행을 가짐 |
6.6 레코드 변환 시점
Kineto 경로에서는 모든 레코드가 구간 종료(stop()) 시점에 일괄 변환됩니다.
프로파일링 구간 도중에는 트레이스에 데이터가 나타나지 않으며, 프로세스가 비정상 종료(SIGKILL 등)될
경우 버퍼에 쌓여 있던 데이터가 그대로 유실됩니다.
6.7 haprof와 Kineto 플러그인 선택 기준
두 방식은 함께 쓰는 관계가 아니라 용도에 맞게 선택해야 하는 대안 관계입니다. 동일 프로세스에서 두 방식을 동시에 활성화할 경우 동일한 활동을 중복 수집하게 되며, 하나뿐인 디바이스 레코드 링의 접근 충돌로 인해 한쪽 트레이스에서 디바이스 활동이 누락될 수 있습니다.
| 비교 항목 | Kineto 플러그인 방식 | haprof 방식 |
|---|---|---|
| 출력 트레이스 형태 | 단일 torch.profiler 통합 출력 파일 |
독립된 .pftrace 및 .json 파일 |
| 프로파일링 적용 범위 | profile() 코드 블록 구간 한정 |
대상 프로세스 전체 실행 기간 |
| CPU 연산 연동 방식 | 흐름 화살표를 통한 자동 연결 | correlation id 직접 대조 필요 |
| 소스 코드 수정 여부 | register() 코드 한 줄 추가 필요 |
수정 불필요(LD_PRELOAD 활용) |
| PyTorch 외 워크로드 | 지원 불가 | 지원 |
| 디바이스 타임라인 수집 | 지원(기본 활성화) | 지원(--runtime-trace) |
| 하드웨어 카운터 수집 | 미지원 | 지원(--device-trace) |
hapti 주석 |
미지원(record_function 사용) |
지원 |
| 시각화 뷰어 | TensorBoard, Perfetto, Chrome tracing | Perfetto, Chrome tracing |
상황별 권장 선택:
- 팀에서 이미
torch.profiler기반의 분석 파이프라인을 구축해 둔 경우 → Kineto 플러그인 - 하드웨어 카운터 분석이 필요한 경우 →
haprof --device-trace - 프로파일링 대상이 PyTorch 외의 일반 C++/Python 프로그램인 경우 →
haprof
다음 단계
- 주석 — 소스 코드 구간에 이름 붙이는 방법
- 디바이스 트레이싱 — 하드웨어 카운터 상세 분석
- Python API —
hapti.kineto.register함수 시그니처