프로그래밍 모델
Legato에서는 실행 컨텍스트, 타입이 지정된 값, 명시적인 데이터 이동으로 커널을 작성합니다. 이들은 프로그래밍을 위한 추상화이며, 컴파일러가 유효한 프로그램을 선택한 백엔드에 맞게 변환합니다.
LPU compute model
아래 그림은 프로그래머 관점에서 LPU를 표현한 추상적인 compute model입니다. 실제 하드웨어의 물리 구현을 정확히 나타내는 구성도는 아닙니다. 컴파일러가 사용할 실행 자원과 메모리 자원을 표현하며, 선택한 백엔드가 각 자원의 구성과 요구 사항을 제공합니다.
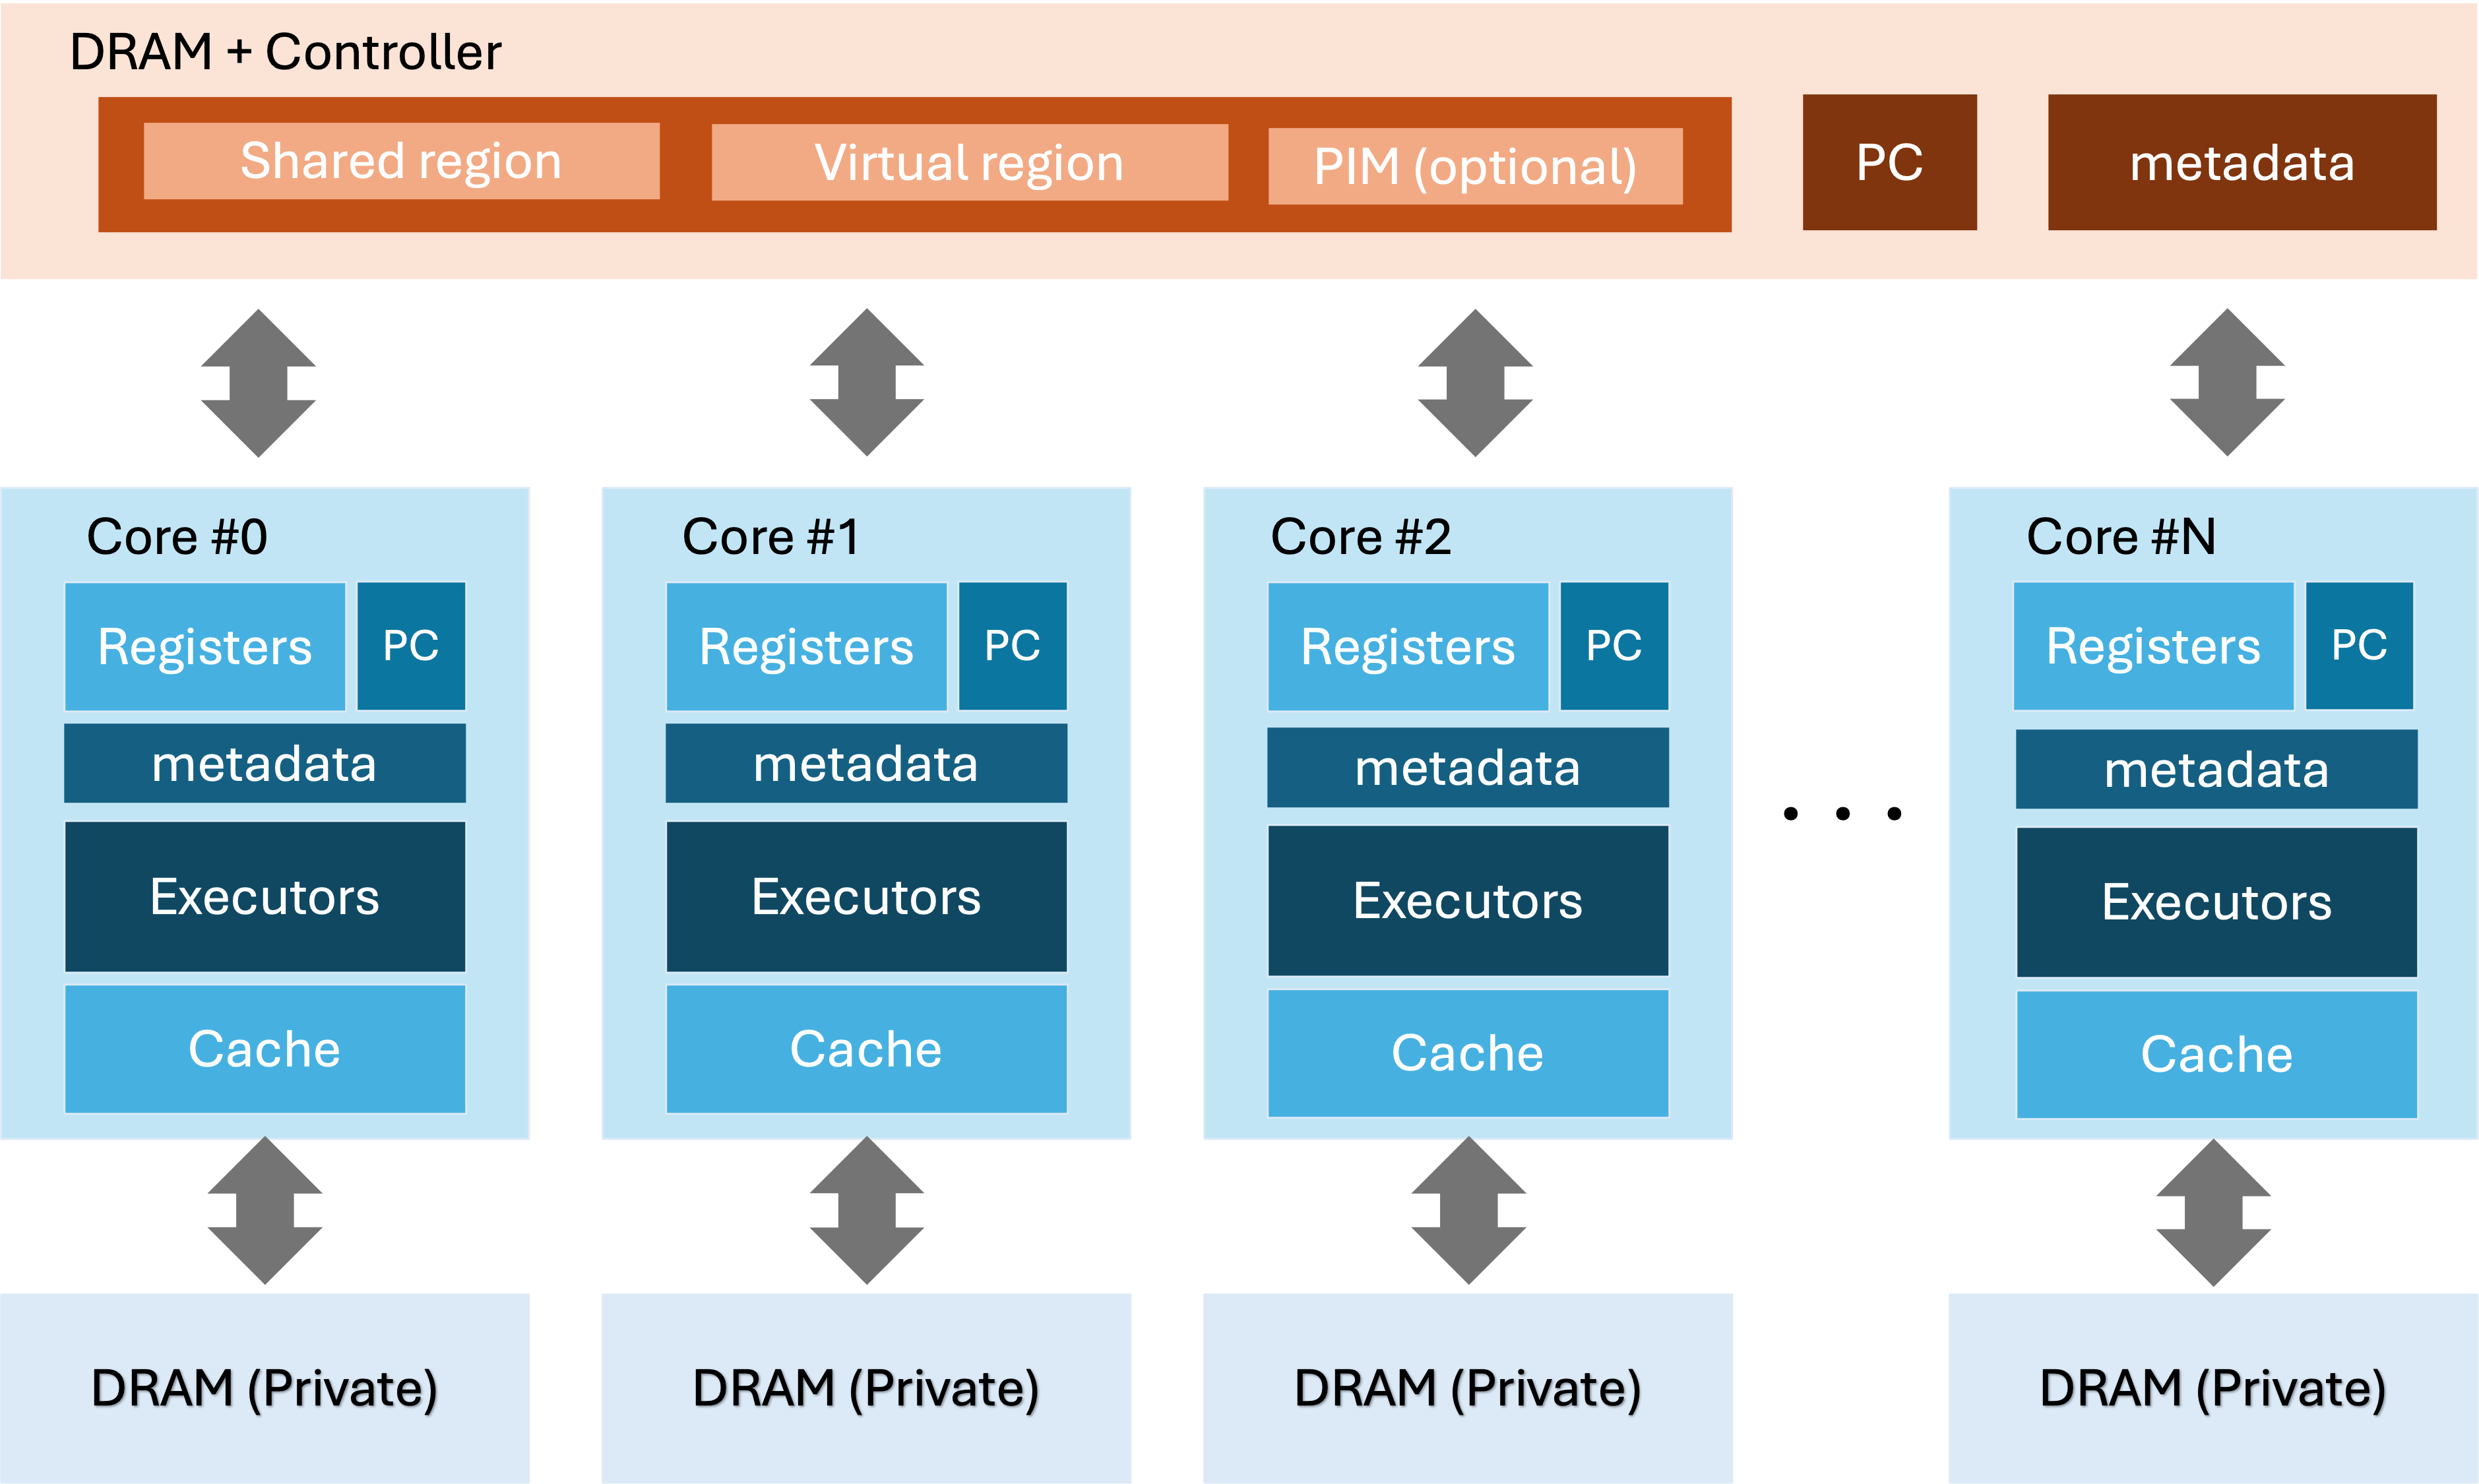
구성 요소와 역할
| 구성 요소 | 프로그래밍 모델에서의 역할 |
|---|---|
| DRAM + Controller | 코어의 계산과 독립적으로 공유 DRAM의 데이터를 코어에 공급합니다. PC는 프로그램의 실행 위치를, metadata는 조정할 작업 정보를 나타냅니다. |
| Shared / Virtual region | 코어들이 함께 사용하는 메모리입니다. Virtual region은 주소 변환을 통해 접근하는 공유 메모리를 나타냅니다. |
| PIM (선택 사항) | 선택적인 processing-in-memory 지원을 나타냅니다. 사용 가능 여부는 선택한 compute model에 따라 달라집니다. |
| Core #0부터 #N | 코어 로컬 프로그램을 실행합니다. 각 코어는 program counter(PC), 레지스터, 실행 유닛, 로컬 메모리 자원을 가집니다. |
| Execution units | 행렬·벡터·reshape·load/store 연산을 수행합니다. Bertha 문서에서는 행렬 유닛과 벡터 유닛을 각각 MPU와 VPU라고 부릅니다. 컴파일러가 지원되는 연산을 적절한 유닛에 할당합니다. |
| Cache / Private DRAM | 코어 로컬 메모리 자원을 나타냅니다. 이 모델에서 Cache는 on-chip SRAM에 해당하고, Private DRAM은 코어의 작업을 위해 구분한 저장 공간입니다. |
이 모델은 shared DRAM, virtual shared memory, 코어 로컬 메모리를 구분합니다. 프로그래머 관점의 코어 메모리는 SRAM과 private DRAM을 합친 공간이며, 컴파일러는 선택한 모델의 제약 안에서 메모리 배치를 계획합니다.
Layout map은 텐서 index를 저장 공간의 주소에 대응시킵니다. 메모리마다 정렬·shape·크기 조건을 둘 수 있고, padding과 swizzling으로 조건을 맞추거나 접근을 여러 bank에 분산할 수 있습니다. 논리 shape은 연산에서 사용하는 데이터의 크기이고, 물리 shape은 할당된 저장 용량입니다. 레이아웃과 메모리 종류를 참고하십시오.
실행 컨텍스트
| 컨텍스트 | 선택 방법 | 커널에서의 역할 |
|---|---|---|
| Top | device.get_top() |
입력 요청과 참여 코어가 함께 사용하는 작업을 조정합니다. |
| 코어 하나 | device.get_core(i) |
선택한 코어가 수행할 연산을 기술합니다. |
| 여러 코어 | device.get_cores(...) 또는 device.get_all_cores() |
참여하는 각 코어의 작업을 기술합니다. |
디바이스 구성에 맞는 백엔드를 만들고, legato.get_context().get_device()를 통해
실행 컨텍스트를 얻으십시오. 코어 index는 구성된 코어 수 범위 안에서 선택해야 합니다.
값은 자신이 정의된 컨텍스트에 속합니다. 컨텍스트 밖으로 값을 내보내려면 yield를 사용하십시오.
컨텍스트 관리를 참고하십시오.
메모리와 데이터 이동
텐서 타입은 커널이 기대하는 원소 타입, 논리 shape, 물리 용량, 저장 종류를 기술합니다. 공유 저장 공간과 코어 로컬 저장 공간은 할당 범위와 정렬 요구 사항이 다릅니다.
| 연산 | 프로그래밍 규약 |
|---|---|
legato.tensor.request_load |
입력을 대상 컨텍스트에서 사용할 수 있도록 요청합니다. |
legato.tensor.receive / receive_type |
대상 컨텍스트에서 요청한 값을 얻습니다. |
legato.tensor.memcpy |
기존 텐서나 view에 결과를 복사합니다. |
문서에 설명된 순서대로 요청과 수신을 짝지으십시오. 선언한 물리 용량과 저장 종류에 맞는 backing 저장 공간을 할당해야 합니다. 어노테이션을 바꾸는 것만으로 그 공간이 할당되거나 초기화되지는 않습니다. 메모리 연산과 PyTorch 연동을 참고하십시오.
디바이스 구성
구성된 그룹 수와 코어 수, 메모리 용량과 word 크기, 채널 수와 주소 간격, MAC 크기, 재사용 한도는 유효한 프로그램의 범위를 정합니다. 선택한 디바이스와 런타임에 맞는 구성을 사용하십시오. 한 백엔드나 revision이 지원하는 값을 다른 백엔드나 revision도 지원한다고 가정해서는 안 됩니다.
컴파일러는 인자 binding, shape, 저장 공간 요구 사항, 타겟 지원 여부를 검사합니다. 프론트엔드 컴파일이 성공했다고 해서 바이너리 컴파일이나 디바이스 실행까지 지원된다는 뜻은 아닙니다. 컴파일 diagnostics 예제를 참고하십시오.