4. 스트림과 이벤트
호스트가 비동기 API를 호출하면 API는 작업을 스트림에 넣고 완료를 기다리지 않고 반환합니다. 스트림은 디바이스에서 실행할 작업을 차례로 담는 큐로, 같은 스트림에 넣은 작업은 넣은 순서대로 실행됩니다. 호출이 반환되어도 디바이스에서는 작업이 끝나지 않았을 수 있으므로, 결과를 쓰기 전에 작업이 끝났는지 확인해야 합니다.
완료는 두 가지 방법으로 확인합니다. 스트림을 동기화하면 그때까지 넣은 작업이 모두 끝날 때까지 기다립니다. 이벤트는 스트림의 한 지점을 표시하며, 그 지점까지의 완료만 확인하거나 다른 스트림이 그 지점을 기다리게 할 때 씁니다.
동기화 누락에 따른 영향
스트림과 이벤트는 성능 최적화 수단일 뿐 아니라 시스템 정확성(Correctness)을 보장하는 핵심 인프라입니다.
- 데이터 일관성: 실행 순서를 명시하지 않으면 의도하지 않은 연산 순서로 결과가 오염될 수 있습니다. 동기화 경계를 누락하면 디바이스가 아직 사용 중인 버퍼를 호스트가 조기에 참조하여 데이터 오염을 유발할 수도 있습니다.
- 디버깅 난이도: 동기화 누락으로 인한 결함은 저부하 상황에서는 정상 동작처럼 보이다가, 프로덕션 등 고부하 상황에서만 간헐적으로 드러나는 경우가 많습니다. 크래시 없이 결과만 조용히 틀어지는 형태로 나타나 원인 규명이 특히 까다로우므로, 비동기 코드를 작성할 때는 처음부터 철저한 동기화 설계가 필요합니다.
Contents
| Section | Objective |
|---|---|
| 4.1 스트림 (Stream) | 순서가 보장되는 범위, 기본 스트림, 개수 제한, 비동기 할당 |
| 4.2 이벤트 (Event) | 스트림의 한 지점을 표시하고 기다리기 |
| 4.3 스트림 간 의존성과 동기화 지점 고르기 | 스트림 간 의존성 구성, 무엇을 기다리고 무엇을 기다리지 않을지 |
| 4.4 수명과 디바이스 리셋 (Lifetime & Device Reset) | 핸들이 언제 무효가 되는지 |
4.1 스트림 (Stream)
스트림(Stream)은 대상 디바이스 상에서 직렬로 처리되는 엄격한 순서 보장 큐(Ordered Queue) 모델을 제공합니다.
- 동일 스트림 내 실행 (Intra-stream): 동일한 스트림 내에 발행(Issue)된 개별 연산 커맨드는 프로그램 순서(Program Order)를 엄격히 준수하여 실행됩니다.
- 복수 스트림 간 관계 (Inter-stream): 서로 다른 스트림에 할당된 연산들 간에는 이벤트(Event) 객체를 통해 명시적인 의존성을 구성하지 않는 한, 비동기 실행 간의 상대적 순서(Execution Order)에 대한 아키텍처적 보장이 제공되지 않습니다.
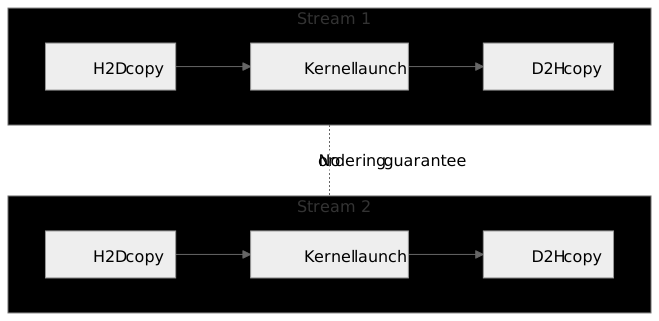
스트림 내부는 순서가 보장되지만, 스트림 간에는 보장되지 않습니다
1 2 3 4 5 6 7 8 | |
1 2 3 4 5 6 7 8 9 | |
| API (Python / C++) | 동기 여부 | 동작 |
|---|---|---|
stream_create() / HaStreamCreate() |
— | 현재 디바이스에 스트림을 생성 |
stream_destroy() / HaStreamDestroy() |
Sync | 큐잉된 작업이 끝나기를 기다린 뒤 파괴. 그 작업이 실패했어도 파괴되며, 그 에러를 반환 |
stream_synchronize() / HaStreamSynchronize() |
Sync | 큐잉된 모든 작업이 완료되면 반환 |
stream_query() / HaStreamQuery() |
Sync | 유휴면 HaSuccess, 진행 중이면 HaStreamNotReady(Python: True / False 반환) |
stream_wait_event() / HaStreamWaitEvent() |
Async | 스트림이 이벤트를 기다리게 함. 디바이스 실행만 직렬화됨 |
stream_get_device() / HaStreamGetDevice() |
Sync | 스트림이 속한 디바이스를 반환 |
기본 스트림 (Default Stream)
명시적인 스트림 핸들을 생성하는 대신 예약된 상수인 HA_STREAM_DEFAULT(C++:
nullptr, Python: 0)를 인자로 전달하면, 런타임이 내부적으로 관리하는 기본
스트림 인스턴스가 암묵적으로 바인딩됩니다.
기본 스트림은 디바이스 전체가 공유하지 않고 디바이스마다 스레드별(Per-thread)로 독립 관리되며, 다음과 같은 아키텍처적 특징을 가집니다.
- 스레드별 독립성: 각 호스트 스레드는 디바이스마다 자신만의 기본 스트림을
가집니다. 동일한 디바이스를 대상으로 서로 다른 호스트 스레드가 각각
HA_STREAM_DEFAULT를 사용할 경우, 각 스레드의 연산은 상호 독립적으로 처리되며 서로 순서가 정해지지 않습니다. - CUDA 모델과의 비교: 이는 CUDA의 스레드별 기본 스트림(Per-thread Default Stream) 동작과 동일하며, 모든 호스트 스레드를 강제로 동기화하던 레거시 기본 스트림(Legacy Default Stream)과 구별되는 설계입니다.
- 사용 지침: 여러 스레드 간의 실행 순서를 일치시켜야 하는 경우, 명시적으로 생성한 스트림을 공유하거나 이벤트를 통해 순서를 직접 제어하는 방식을 사용해야 합니다.
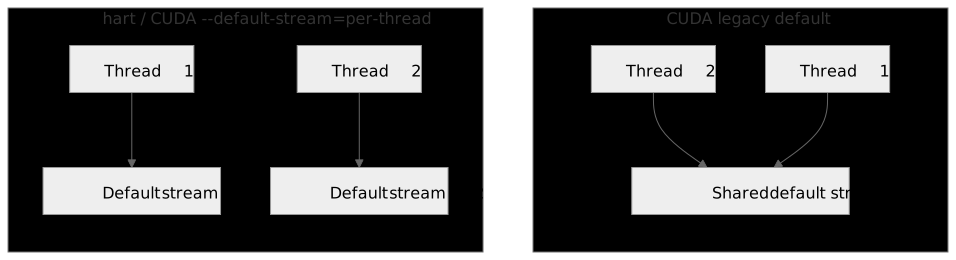
스레드별 기본 스트림(PTDS)과 CUDA 레거시 기본값의 대조
CUDA는 컴파일 옵션으로 PTDS를 선택할 수 있지만, hart는 항상 PTDS로 동작합니다.
스트림 개수 제한 (Stream Count Limit)
디바이스 하나에 stream_create()(C++: HaStreamCreate())로
만들 수 있는 스트림은 최대 10개입니다. 이 상한은 명시적 스트림(Explicit Stream)에만 적용되며,
스레드별 기본 스트림은 이 제한에 포함되지 않습니다.
- 권장 패턴 (Pre-allocation): 파이프라인 처리에 요구되는 명시적 스트림 집합은 초기화(Initialization) 단계에서 사전에 일괄 생성하여 프로세스 수명 주기 동안 재사용해야 합니다.
- 안티패턴 방지: 요청(Request) 단위로 스트림을 동적으로 생성하는 방식은 상한 초과로 인한 생성 실패를 유발하므로 지양해야 합니다.
비동기 할당 (Asynchronous Allocation)
스트림은 연산 커맨드뿐만 아니라 메모리 관리 작업까지 비동기 파이프라인에 통합할 수 있습니다. 메모리 할당(Allocation)과 해제(Deallocation) 연산 역시 커널 실행과 동일하게, 스트림(Stream)의 순서화된 실행 큐(Execution Queue)에 직접 인큐잉(Enqueue)하여 비동기적으로 처리됩니다.
1 2 3 | |
1 2 3 4 | |
비동기 메모리 연산은 다음 두 가지 핵심 규칙 내에서 동작합니다.
- 할당 포인터 사용 (
mem_alloc_async):mem_alloc_async()(C++:HaMemAllocAsync())가 반환하는 포인터는 반환 즉시 동일 스트림의 후속 연산 큐잉에 바로 사용할 수 있습니다. 단, 할당은 스트림이 그 지점에 도달해야 사용 가능해지므로, 이 포인터를 호스트에서 다루거나 동기(Synchronous) API·다른 스트림의 연산에 넘기기 전에는 스트림을 동기화해야 합니다. - 해제 후 소유권 (
mem_free_async):mem_free_async()(C++:HaMemFreeAsync()) 호출 이후, 실제 하드웨어의 메모리 회수 작업이 백그라운드 스트림 순서에 따라 지연되더라도 해당 포인터에 대한 애플리케이션의 소유권(Ownership)은 호출과 동시에 즉시 종료되므로 임의로 재사용해서는 안 됩니다.
비동기 방식으로 할당된 메모리는 스트림 동기화가 완전히 완료된 후 동기식 인터페이스인
mem_free()(C++: HaMemFree())를 통해 해제할 수 있으며, 또는 동일한 스트림에서 mem_free_async()(C++: HaMemFreeAsync())를 호출하여 비동기적으로 해제하는
것도 가능합니다.
4.2 이벤트 (Event)
이벤트(Event)는 스트림의 한 지점을 표시하는 동기화 객체입니다. 스트림에 기록(Record)한 이벤트는 호스트 스레드가 그 지점까지의 완료를 기다리거나, 다른 스트림이 그 지점 이후에 실행되도록 의존성(Dependency)을 걸 때 사용합니다.
한 스트림이 이벤트를 기록하고 다른 스트림이 그 이벤트를 기다리는, 점대점 (Point-to-point) 의존성의 기본 형태는 다음과 같습니다.
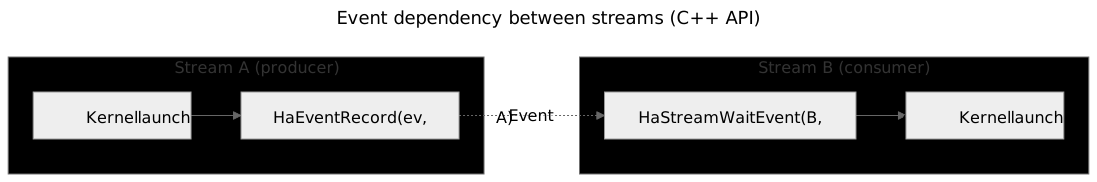
스트림-이벤트 점대점(Point-to-point) 의존성 (C++ API 기준. Python: event_record(), stream_wait_event())
1 2 3 4 5 6 7 8 9 10 11 12 13 | |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | |
| API (Python / C++) | 동기 여부 | 설명 |
|---|---|---|
event_create() / HaEventCreate() |
— | 이벤트 객체 생성 |
event_destroy() / HaEventDestroy() |
Sync | 이벤트 객체 파괴. 기록한 이벤트는 그 기록이 스트림에서 처리될 때까지 기다린 뒤 파괴 |
event_record() / HaEventRecord() |
Async | 이벤트 표식을 스트림에 인큐잉(Enqueue) |
event_synchronize() / HaEventSynchronize() |
Sync | 이벤트가 기록된 시점까지 스트림 실행 완료를 대기 (기록된 적 없으면 HaEventNotRecorded) |
event_query() / HaEventQuery() |
Sync | 이벤트 상태를 즉시 조회 (HaSuccess / HaEventNotReady / HaEventNotRecorded) |
이벤트 파괴 시 주의사항
스트림이 아직 대기 중인 이벤트 객체는 조기에 파괴(Destroy)해서는 안 됩니다. 이벤트가 유효하게 유지되도록 스트림의 처리 완료 시점을 반드시 확인해야 합니다.
이벤트 기록 (event_record)의 동작과 예외 처리
- 비동기 기록 (Async):
event_record()(C++:HaEventRecord())는 스트림에 완료 표식을 남기는 작업으로, 연산 완료를 기다리지 않고 즉시 반환됩니다. 이벤트가 실질적인 '완료 상태'로 전이되는 시점은 스트림의 선행 연산이 실제로 모두 끝난 뒤입니다. - 한 번만 기록: 이벤트는 한 번만 기록할 수 있습니다. 이미 기록한 이벤트에
다시
event_record()를 호출하면HaEventInvalidArgument가 반환됩니다. 다른 지점을 표시하려면 이벤트를 새로 만드십시오. - 실패 시 상태: 기록에 실패하면 이벤트는 기록되지 않은 상태로 남습니다. 이벤트를 파괴하거나 새로 만들 필요 없이 그대로 다시 기록할 수 있습니다.
이벤트 대기 및 조회 (event_synchronize / event_query)
- 동기 대기 (
event_synchronize):event_synchronize()(C++:HaEventSynchronize())는 이벤트가 완료될 때까지 호출 스레드를 블로킹합니다. 단, 해당 이벤트가 한 번도 기록(Record)된 적이 없다면 무한정 대기하지 않고 즉시HaEventNotRecorded를 반환합니다. 스트림의 모든 작업을 기다리는stream_synchronize()와 달리, 특정 한 지점만을 정밀하게 대기할 때 유용합니다. - 즉시 조회 (
event_query):event_query()(C++:HaEventQuery())는 이벤트 상태를 즉시 조회하며, 서로 구분되는 두 가지 미완료 상태를 반환합니다.HaEventNotReady는 기록은 되었으나 아직 연산이 완료되지 않은 경우이고,HaEventNotRecorded는 애초에event_record()가 호출된 적이 없는 경우입니다. 폴링 루프 구성 시 두 상태를 명확히 구분하여 처리해야 잘못된 대기 로직을 방지할 수 있습니다.
4.3 스트림 간 의존성과 동기화 지점 고르기
stream_wait_event()를 통한 스트림 간 의존성 구성
스트림에서 언급했듯, 서로 다른 스트림에 걸친 실행 순서는
이벤트를 매개로 한 명시적인 의존성 구성 없이는 보장되지 않습니다.
stream_wait_event()(C++: HaStreamWaitEvent())는 호스트 스레드를 블로킹하지
않고, 디바이스 하드웨어 레벨의 스트림 간 의존성 커맨드를 대상 스트림의 큐에
삽입한 뒤 바로 반환하는 비동기(Async) 호출입니다.
이러한 비동기 의존성 제어는 백그라운드 데이터 전송과 커널 연산을 타임라인 상에서 완벽하게 중첩(Overlap)시켜, 파이프라인의 병목을 해소하고 처리량(Throughput)을 극대화하는 핵심 아키텍처 도구입니다.
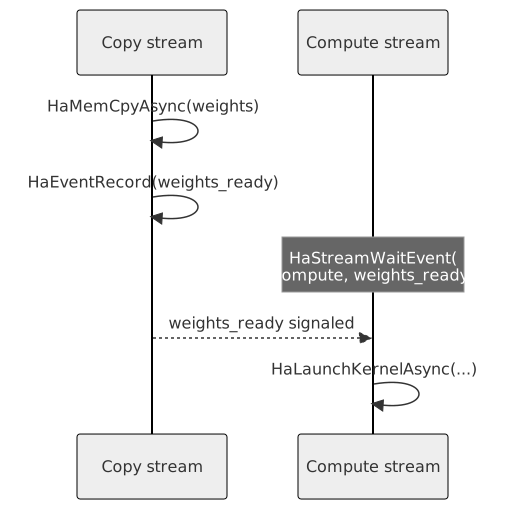
복사 스트림과 연산 스트림의 이벤트 기반 의존성 예시
동기화 지점 판단 기준
확인하고자 하는 완료 범위(Scope)와 실행 의존성에 따라 적합한 동기화 API를 선택해야 합니다. 최소한의 범위만 정밀하게 동기화해야 호스트 스레드의 불필요한 블로킹을 방지하여 전체 처리량(Throughput)을 최적화할 수 있습니다.
| 판단 기준(Criterion) | 권장 API (Python / C++) |
|---|---|
| 이 스트림에 넣은 모든 작업이 끝났는가 | stream_synchronize(stream) / HaStreamSynchronize(stream) |
| 특정 지점까지 끝났는가 | event_record()/HaEventRecord() 후 event_synchronize()/HaEventSynchronize() |
| 기다리지 않고 끝났는지만 확인 | stream_query()/HaStreamQuery() · event_query()/HaEventQuery() |
| 스트림 B가 스트림 A의 특정 지점 이후에 시작해야 함 | event_record()/HaEventRecord() 후 stream_wait_event()/HaStreamWaitEvent() |
4.4 수명과 디바이스 리셋 (Lifetime & Device Reset)
스트림과 이벤트 객체의 수명은 이를 생성한 디바이스에 종속됩니다. 디바이스를 리셋하면
그 디바이스의 모든 리소스가 해제되며, 소속된 모든 스트림과 이벤트 객체도 함께 파괴됩니다.
리셋한 디바이스를 다시 쓰려면 스레드마다 set_device()(C++: HaSetDevice())를
다시 호출해야 합니다.
리셋이 진행되는 동안 그 디바이스를 대상으로 새로 발행되는 모든 연산(메모리 할당·해제·전송,
커널 실행, 스트림·이벤트 작업 등)은 HaDeviceNotReady를 반환하며 즉시 거부됩니다.
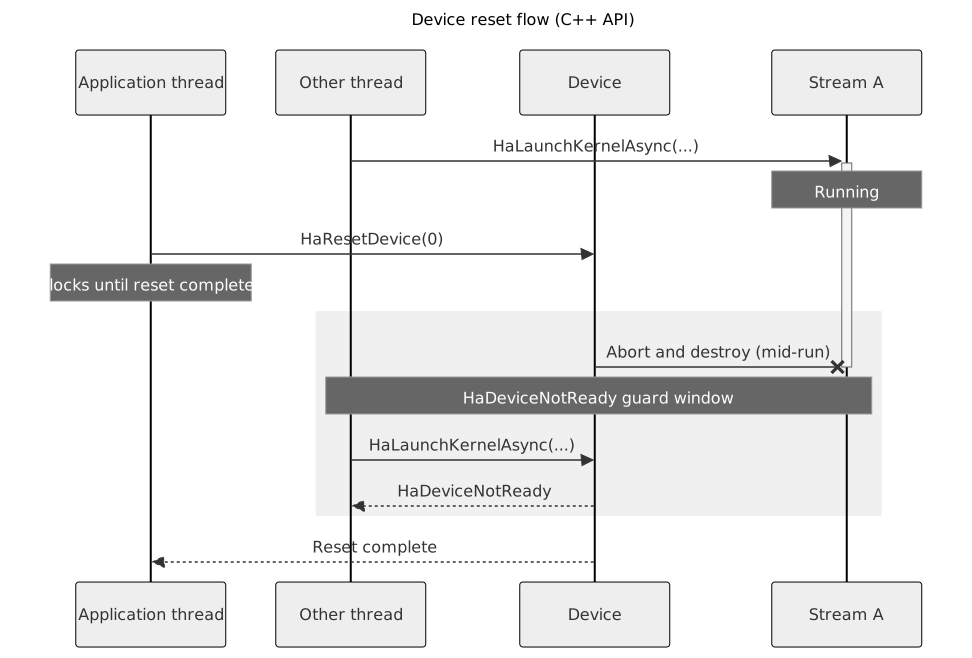
디바이스 리셋 전환 구간에서의 디바이스·스트림·이벤트 상태 변화 (C++ API 기준. Python: launch_kernel_async_with_binary_path(), reset_device())
리셋에 따른 스트림 및 이벤트 무효화
reset_device()(C++: HaResetDevice()) 또는 reset_all_devices()(C++:
HaResetAllDevices()) 호출 이후, 해당 디바이스에 종속되어 있던 모든 스트림 및
이벤트 핸들은 즉시 낡은 상태(Stale State)로 전이됩니다. 무효화된 핸들로 호출하면
HaStreamInvalidHandle·HaEventInvalidHandle로 거부되므로, 리셋 수행 전에 관련
핸들을 명시적으로 파괴하고, 리셋 완료 후에 필요한 핸들을 새로 생성해야 합니다.
무효화된 핸들(Stale Handle)에 대한 관리 책임
리셋이 진행되는 동안 신규로 유입되는 연산은 HaDeviceNotReady로 차단되고, 리셋 완료
이후 남아 있는 낡은 스트림·이벤트 핸들은 위의 에러 코드로 거부됩니다. 디바이스 포인터는
전송에서 HaMemoryInvalidAddress, 해제에서 HaMemoryFreeFailed로 거부되지만, 리셋 이후 새 할당이 같은 주소를 받으면 이전 포인터가
새 할당을 가리키게 되어 거부되지 않습니다. 따라서 개발자가 직접 생명주기를 엄격하게
관리해야 합니다.