5. 멀티 디바이스 프로그래밍
디바이스는 API 호출의 인자가 아니라, 호출한 스레드에 지정한 디바이스로 정해집니다. 그래서
mem_alloc()(C++: HaMemAlloc())이나 launch_kernel_with_binary_path()(C++: HaLaunchKernel())에는
디바이스 인자가 없습니다. 호출마다 디바이스를 넘길 필요는 없지만, 스레드마다 사용할 디바이스를 직접 지정해야
합니다. 이 장에서는 그 방법과 주의할 점을 다룹니다.
런타임과 애플리케이션의 역할은 다음과 같이 나뉩니다.
- 런타임 — 포인터를 받는
mem_free()(C++:HaMemFree())와mem_cpy()(C++:HaMemCpy())는 포인터가 속한 디바이스에서 동작합니다. 디바이스 사이의 복사도mem_cpy()로 처리하며, 별도의 피어 복사 API는 없습니다. - 애플리케이션 — 스레드마다 사용할 디바이스를
set_device()(C++:HaSetDevice())로 지정합니다.
단일 디바이스 코드를 멀티 디바이스로 확장할 때 주로 문제가 되는 곳은 두 가지입니다. 새로 만든 스레드는 부모
스레드의 디바이스 지정을 이어받지 않으므로, set_device()를 호출하지 않으면 바로 에러로 실패합니다. 디바이스를
리셋하면 이전 핸들과 포인터가 무효가 됩니다. 이때 리셋 뒤 새 할당이 같은 주소를 받으면, 이전 포인터가 에러 없이
새 할당을 가리키게 되어 원인을 찾기 어렵습니다. 아래에서 각각의 원인과 대처법을 다룹니다.
Contents
| Section | Objective |
|---|---|
| 5.1 현재 디바이스 | 현재 디바이스 관리 규칙과 그에 따른 동작 결과 |
| 5.2 멀티 디바이스 프로그램의 두 가지 구조 | 디바이스당 한 스레드 방식 vs 하나의 스레드가 디바이스를 전환하는 방식 비교 |
| 5.3 가상 디바이스 ID | 물리 ID와 분리된 관리 방식, 인덱스 공백(Hole) 방지 메커니즘 |
| 5.4 디바이스 간 데이터 이동 | Peer 전송의 수행 조건과 집합 통신(Collective Communication) 간의 경계 |
| 5.5 멀티 디바이스 프로세스에서의 리셋 | 프로세스 전체 영역에 영향을 미치는 리셋 연산의 특성 |
5.1 현재 디바이스 (Current Device)
mem_alloc()(C++: HaMemAlloc()), launch_kernel_with_binary_path()(C++:
HaLaunchKernel())을 비롯한 대부분의 주요 진입점에는 디바이스를 직접 지정하는
파라미터가 존재하지 않습니다. 대신, 해당 API들은 set_device()(C++: HaSetDevice())
인터페이스로 사전에 설정된 현재 디바이스를 기준으로 동작하며, 별도의
기본값(Default)은 제공되지 않습니다.
1 2 3 4 5 6 | |
1 2 3 4 5 6 7 8 9 10 | |
이러한 설계로부터 파생되는 핵심 아키텍처 특징은 다음과 같습니다.
- 새로 생성된 스레드의 디바이스 미지정 문제 — 새로 생성된 스레드에는 기본
현재 디바이스가 설정되어 있지 않습니다. 런타임 API를 호출하는 모든 워커
스레드는 반드시 실행 직후
set_device()(C++:HaSetDevice())를 명시적으로 호출해야 합니다. 이를 거치지 않은 스레드가 런타임 연산을 시도할 경우HaDeviceInvalidArgument에러와 함께 즉시 실패합니다. 이러한 제약은 애플리케이션 개발자가 직접 생성한 스레드뿐만 아니라, 백그라운드 스레드 풀(Thread Pool)이나 외부 프레임워크가 내부적으로 생성한 워커 스레드에도 예외 없이 적용됩니다. - 디바이스 설정과 실행 동기화의 독립성 — 현재 디바이스 설정은 실행 동기화 락(Lock)이 아닙니다. 스레드가 현재 디바이스를 다른 번호로 전환한다고 해서, 이전 디바이스 상에서 이미 발행되어 진행 중이던 비동기 작업들이 완료될 때까지 런타임이 블로킹 방식으로 대기해 주지 않습니다.
5.2 멀티 디바이스 프로그램의 두 가지 구조
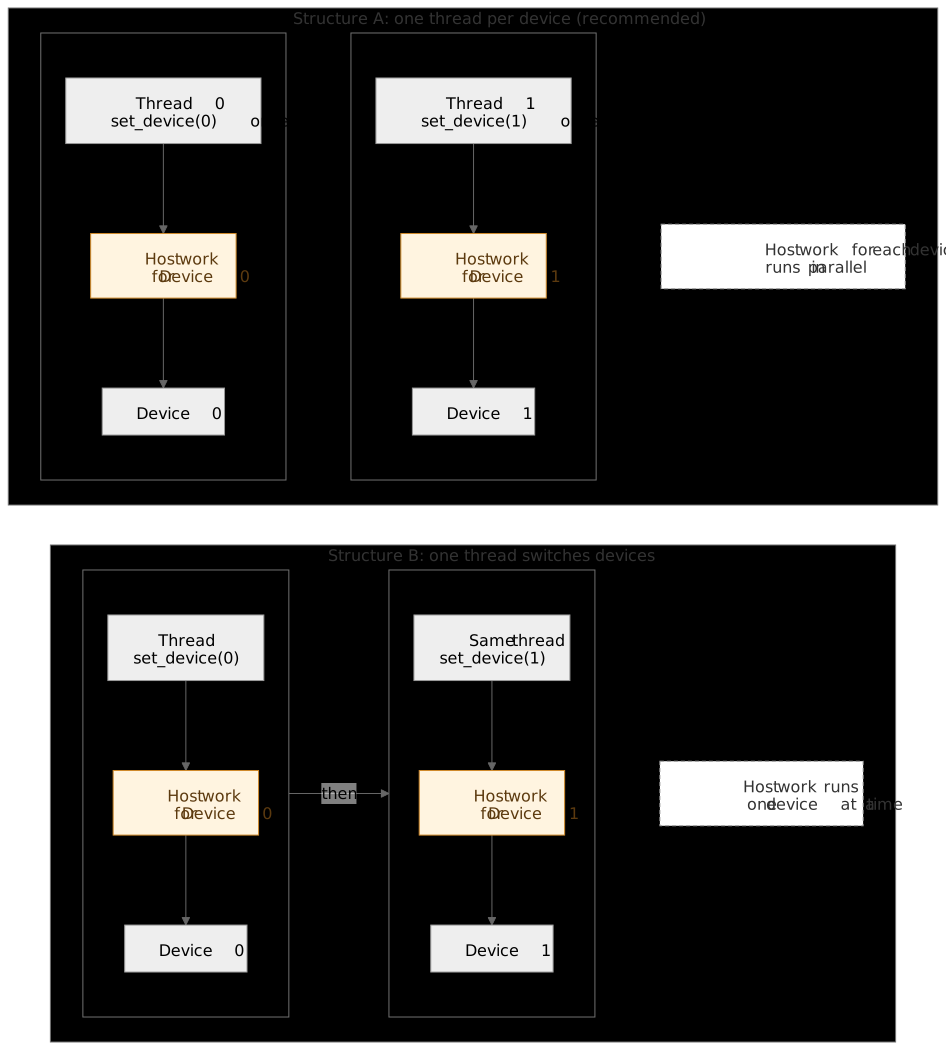
디바이스당 스레드 하나(구조 A)와 스레드 하나가 디바이스를 전환하는 구조(구조 B)
구조 A: 디바이스당 스레드 하나 (권장). 각 워커 스레드가 시작 시점에 디바이스를 한 번만 설정하고 이후 변경하지 않는 구조입니다. 이는 런타임이 전제하는 자연스러운 실행 모델이기도 합니다. 디바이스별 실행기(Executor)가 서로 완전히 독립적으로 동작하며, 스레드 간에 잘못 공유될 여지가 있는 상태 자체가 존재하지 않습니다.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | |
구조 B: 단일 스레드가 디바이스를 순회하며 전환. 이 구조는 호스트 측 실행이 직렬화(Serialize)되므로 정상 상태(Steady-state)의 서빙 루프에 사용하기에는 적합하지 않습니다. 하지만 초기화나 정리(Cleanup) 작업처럼 한시적으로 여러 디바이스를 순회해야 하는 경우에는 유용하게 활용될 수 있습니다.
1 2 3 | |
1 2 3 4 5 6 | |
5.3 가상 디바이스 ID (Virtual Device ID)
앞서 살펴본 두 가지 구조의 예시 코드에서 볼 수 있듯이, 디바이스 순회 시
사용되는 인덱스는 항상 [0, HaGetDeviceCount()) 범위를 안전하게 만족합니다.
이 범위가 깨지지 않고 안전하게 성립하는 이유는 HaSetDevice()에 전달하는
값이 하드웨어의 물리 ID가 아니라, 런타임이 부여하는 가상 ID이기 때문입니다.
- 하드웨어 물리 ID와의 분리 관리 — 런타임은 디바이스 스캔 과정에서 발견된
순서대로
k번째 디바이스에 가상 IDk를 부여합니다. 물리 ID는 시스템 구성에 따라 불연속적일 수 있고 초기화에 실패하는 디바이스도 존재하기 때문에, 하드웨어 물리 ID와 소프트웨어 가상 ID를 엄격히 분리하여 관리합니다. - 초기화 실패 시 인덱스 공백(Hole) 방지 — 특정 디바이스의 초기화가
실패하더라도 런타임은 중단되지 않고 정상 디바이스를 중심으로 구동을
유지합니다. 예를 들어 8개의 디바이스가 장착된 시스템에서
HaGetDeviceCount()가 7을 반환한다면, 1개의 디바이스가 초기화에 실패했고 나머지 7장은 정상 작동 중임을 의미합니다. 이 경우 런타임은 정상적으로 초기화된 디바이스만을 대상으로 가상 ID를 0부터 다시 연속적으로 부여하므로, 가상 ID에 인덱스 공백이 발생하지 않습니다. 이는 앞서 본for순회 패턴이 항상 안전하게 성립하는 이유입니다.
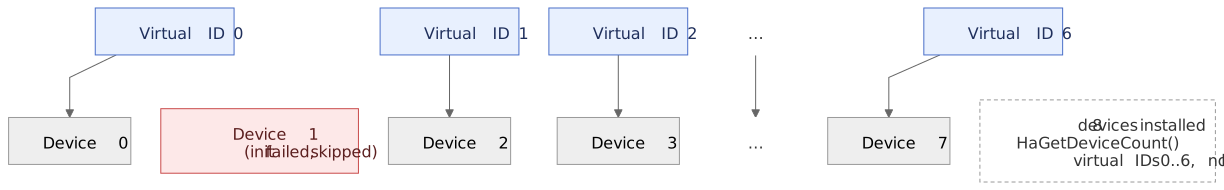
디바이스 8개 중 물리 디바이스 1이 초기화에 실패했을 때의 가상 ID 매핑 예
가상 ID 할당의 유동성
가상 ID가 특정 물리 디바이스를 고정으로 가리킨다고 가정해서는 안 됩니다.
동일한 장비라 하더라도 실행 환경이나 디바이스 구성에 따라 매핑이
달라질 수 있습니다. 하드웨어 장애 진단이나 특정 카드를 직접 지목해야 하는
경우에는 get_device_attribute()(C++: HaGetDeviceAttribute())로
PCI 주소(PCI_DOMAIN, PCI_BUS, PCI_SLOT, PCI_FUNC)를 읽어 카드를 확인하십시오.
5.4 디바이스 간 데이터 이동 (Data Movement Between Devices)
멀티 디바이스 간 데이터 복사는 mem_cpy()의 방향 인자에 DeviceToDevice(Python: hart.HaMemCpyDirection.DeviceToDevice
/ C++: HaMemCpyDirection::DeviceToDevice)를 지정하여 수행합니다.
1 | |
1 | |
이때 호출자가 디바이스 ID를 명시할 필요는 없습니다. 런타임이 포인터 주소 분석을 통해 소속 디바이스를 자동 식별하여 라우팅하며, 소스(Source)와 목적지(Destination)의 디바이스가 상이할 경우 내부적으로 피어(Peer) 전송으로 전환합니다.
피어 전송(Peer Transfer)의 제약 사항
디바이스가 피어 전송을 지원하지 않으면 디바이스 간 복사는 HaMemCpyNotSupported로
실패하며, 호스트 메모리를 경유하는 자동 우회(Fallback)는 제공되지 않습니다. 이때는
D2H와 H2D 두 번의 복사로 나누어 구현해야 합니다.
mem_cpy_async()(C++: HaMemCpyAsync())로 디바이스 간 복사를 할 때는
소스나 목적지 디바이스의 스트림을 넘겨야 합니다. 두 디바이스 어느 쪽에도 속하지 않은 스트림은
HaMemCpyNotSupported로 거부됩니다. 또한 복사가 끝나기 전에 어느 한쪽 디바이스를 리셋하지 않도록,
리셋 전에 그 스트림을 동기화하십시오.
집합 통신(Collective Communication)에는 LCCL 사용 권장
점대점(Point-to-Point) 복사는 일회성 전송에 적합한 도구입니다. all-reduce,
all-gather를 비롯한 집합 통신 패턴은 LCCL의 몫입니다.
LCCL은 링(Ring) 채널을 효율적으로 구성하고 데이터 전송과 연산을 서로
겹쳐서(Overlapping) 수행합니다. 단일
mem_cpy()(C++:
HaMemCpy()) 호출을 여러 개 엮어서
집합 통신을 직접 구현하는 것은 성능상 권장하지 않습니다.
5.5 멀티 디바이스 프로세스에서의 리셋
reset_all_devices()(C++: HaResetAllDevices())는 다른 스레드가 현재 사용
중인 디바이스를 포함하여 프로세스에 연결된 모든 디바이스를 예외 없이
리셋합니다. 이는 특정 디바이스나 스레드에 국한되지 않는, 프로세스 전체에
영향을 미치는 전역(Global) 연산입니다.
다른 스레드가 동작 중일 때 리셋하지 마십시오
리셋은 모든 디바이스의 할당, 스트림, 이벤트를 무효화합니다. 멀티스레드 프로세스에서는 먼저 모든 워커를 정지시키십시오. 스레드별 리셋은 없으며, 런타임이 다른 스레드를 대신 멈춰 주지 않습니다.