HyperAccel Runtime (hart)
HyperAccel Runtime(hart)은 HyperAccel LPU(Language Processing Unit)를 위한 자원 관리 및 실행 계층(Resource Management & Execution Layer)으로, 디바이스와 메모리 자원을 관리하고 커널 로드와 디스패치, 스트림·이벤트 기반의 동기·비동기 실행을 담당하며, 자원을 효율적으로 운용하고 실행 오버헤드를 최소화해 LPU의 연산 성능을 최대한 끌어내는 것을 목표로 설계되었습니다.
멀티 스레드·멀티 디바이스 환경에서 요구되는 스레드별 디바이스 지정, 메모리 주소 기반 디바이스 라우팅, 오버헤드가 낮은 메모리 할당은 모두 hart 내부에서 처리합니다. 따라서 상위 프레임워크와 애플리케이션은
디바이스 관리의 세부 사항을 직접 다루지 않고 연산 흐름 구성에 집중할 수 있습니다.
hart는 상위 AI 프레임워크와 커널 모드 드라이버(KMD) 사이에 위치하는 핵심 인터페이스입니다. PyTorch
백엔드(torch_ha), 모델 서빙(vllm_hyperaccel), 집합 통신(lccl), 프로파일러(hapti) 등 HyperAccel AI
소프트웨어 스택의 주요 컴포넌트가 hart 위에서 동작합니다. 자체 런타임이나 경량 환경처럼 디바이스를 핸들로
직접 다뤄야 하는 소프트웨어는 디바이스 핸들 기반의 Driver API(ha_drv_*)를
사용합니다.
아키텍처 개요
hart 내부는 다음 다섯 영역으로 구성되며, 각 기능은 아래 핵심 특징에 정리되어
있습니다.
- Device & Routing Engine: 하드웨어 디바이스를 탐색·초기화하고 리셋하며, 초기화에 성공한 디바이스에만 0부터 순차적으로 가상 ID를 부여합니다. 또한 스레드별 현재 디바이스와 메모리 포인터의 소유 디바이스를 추적하여 각 호출을 알맞은 대상 디바이스로 라우팅합니다.
- Execution & Synchronization: 작업을 스트림 단위로 큐잉해 동기·비동기 실행을 제공하며, 이벤트를 통해 스트림 간 실행 순서와 완료 시점을 동기화합니다. 커널은 커널 라이브러리에서 이름으로 찾아 실행하며, 각 디바이스의 칩 세대에 맞는 바이너리를 로드합니다.
- Memory Management: 해제된 디바이스 메모리를 재사용해 할당 오버헤드를 줄이고, 메모리 사용량 조회와 반환을 지원합니다. 이 밖에도 호스트 전송 버퍼, KV 캐시용 가상 메모리, 디바이스 간 P2P(Peer-to-Peer) 직접 전송을 관리합니다.
- Weight Conversion: 모델의 가중치 텐서를 양자화 메타데이터와 함께 대상 아키텍처 전용 디바이스 메모리 레이아웃으로 변환합니다. 이 과정은 디바이스 자원을 점유하지 않고 호스트 측에서 독립적으로 수행됩니다.
- Observability & Diagnostics: 표준화된 에러 코드 체계를 통해 실패 원인을 명확히 구분하며,
HyperAccel Profiler(
hapti)가 호스트 측 호출과 디바이스 내부 연산 활동을 상호 연관 지어 추적할 수 있도록 실행 진단 정보를 제공합니다.
Driver API는 위 영역을 거치지 않고 핸들로 디바이스를 직접 다룹니다.
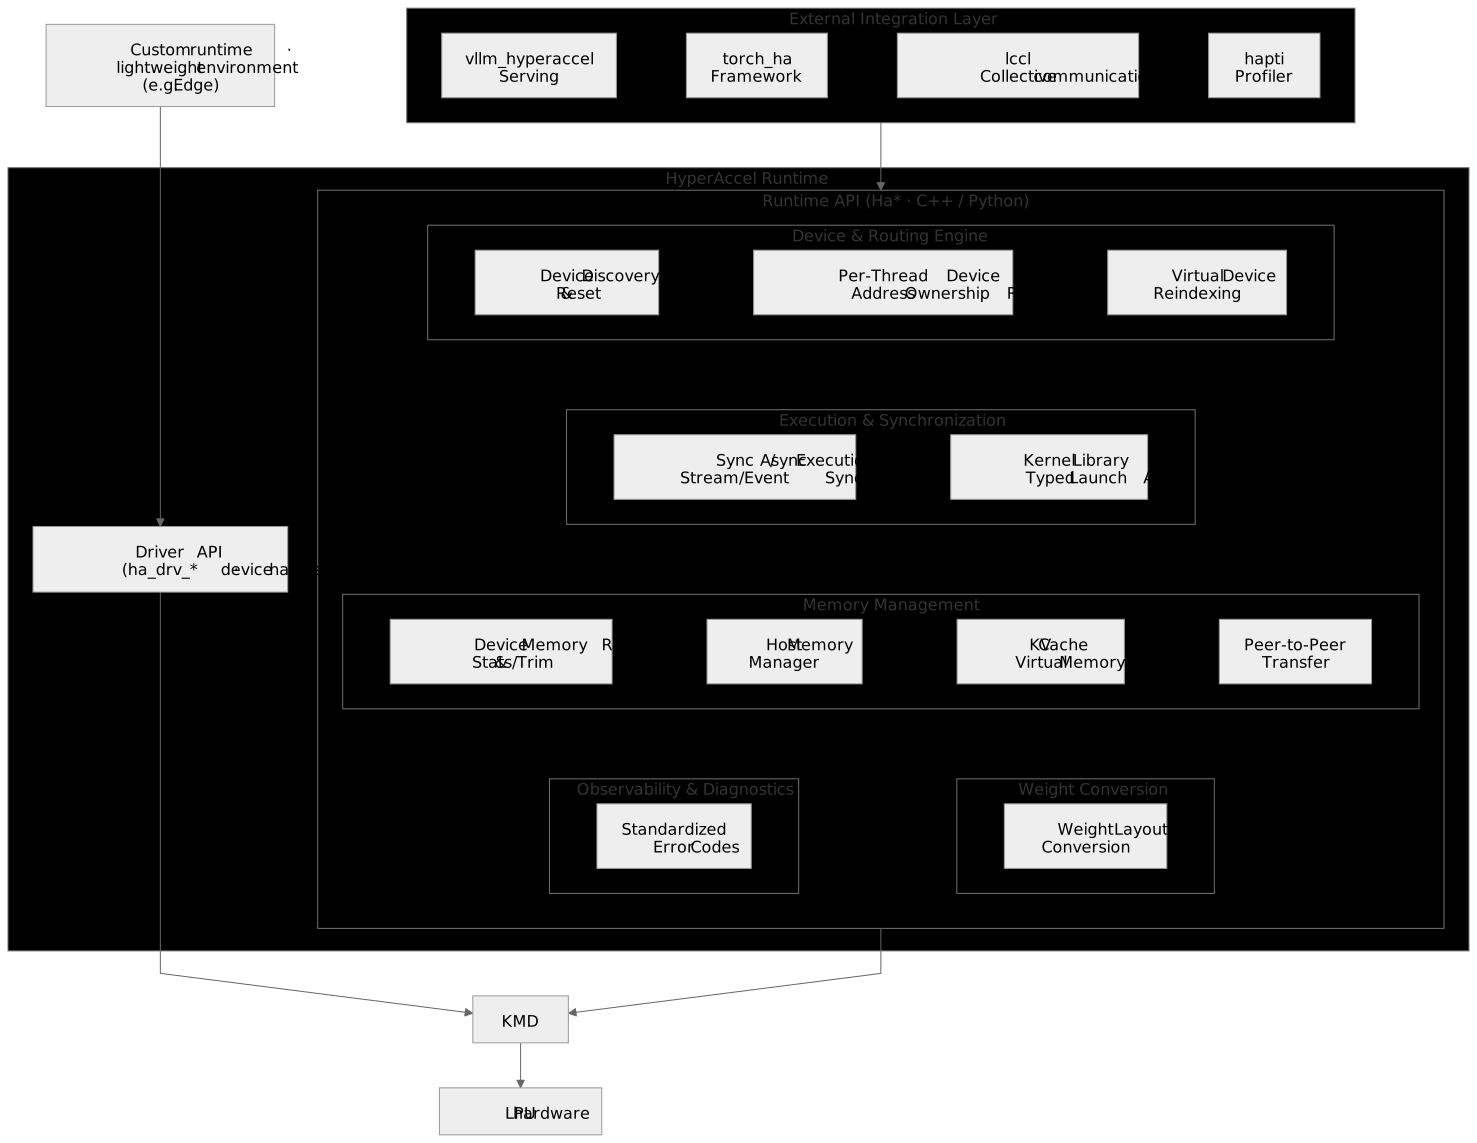
소프트웨어 스택에서의 HyperAccel Runtime 아키텍처와 기능
hart의 핵심 특징
아래 표는 위 영역별 주요 기능을 요약합니다. 자세한 내용은 프로그래밍 가이드와 API 레퍼런스를 참고하십시오.
| 특징 | 설명 |
|---|---|
| CUDA Runtime-Style API | 명명 방식과 사용 흐름을 CUDA 런타임에 맞춰, CUDA에 익숙한 개발자가 쉽게 이해할 수 있습니다(예: cudaMalloc → HaMemAlloc). |
| Device Discovery & Reset | 사용 가능한 디바이스를 확인하고 디바이스 하나 또는 전체를 리셋합니다. 초기화에 실패한 디바이스는 건너뛰고, 정상 디바이스에만 0부터 빈틈없이 가상 ID를 부여합니다. |
| Multi-Threaded Device Routing | 여러 호스트 스레드가 각자 디바이스를 골라 독립적으로 사용할 수 있고, 해제나 복사는 포인터가 속한 디바이스로 자동 전달됩니다. |
| Synchronous & Asynchronous Execution | 커널 실행과 메모리 연산을 동기·비동기로 모두 제공하며, 스트림과 이벤트로 비동기 작업의 순서와 완료 시점을 제어합니다. |
| Kernel Library & Typed Launch | 커널을 라이브러리에서 이름으로 찾아 실행하며, 디바이스마다 칩 세대에 맞는 빌드가 로드됩니다. 인자는 종류와 타입이 기록된 목록으로 넘기므로 커널 규격과 다르면 실행 전에 거부됩니다(커널 라이브러리와 핸들 실행). |
| Memory Reuse, Statistics & Trim | 해제한 디바이스 메모리를 재사용해 할당 오버헤드를 줄이고, 사용량을 조회하거나 쓰이지 않는 메모리를 반환할 수 있습니다(사용량 확인과 반환). |
| Host Memory Manager | 전송용 호스트 버퍼를 프로세스 단위로 할당·재사용하고 사용량 한도를 적용합니다(호스트 메모리). |
| Peer-to-Peer (P2P) Transfer & KV Cache Virtual Memory | 디바이스 간 복사를 호스트를 거치지 않고 직접 처리하며, KV 캐시용 가상 메모리(VMM)로 HW 페이지를 다룹니다(가상 메모리 및 HW 페이지 관리). |
| Weight Conversion | 가중치 텐서를 양자화 메타데이터와 함께 대상 아키텍처의 디바이스 메모리 레이아웃으로 변환합니다(가중치 변환). |
| Standardized Error Codes | C++은 HaError 코드를, Python은 같은 코드 이름을 담은 RuntimeError를 보고하므로 실패 원인을 코드로 구분할 수 있습니다. |
한눈에 보기
| 항목 | 명세 |
|---|---|
| 패키지 | hart |
| 버전 | 0.0.6 |
| 언어 | C++20 코어, Python 바인딩(pybind11) |
| 산출물 | C++ 라이브러리(CMake 패키지 hart), hart Python 모듈 |
| 공개 헤더 | ha_runtime_api.h, ha_driver_api.h, ha_driver_types.h, ha_types.h, ha_error_code.h, ha_error.h, ha_vmm.h, ha_callback_params.h, ha_weight_converter.h, ha_weight_converter_types.h |
| Python | 3.10 – 3.12 |
| 상태 | Beta |
API 개요
hart는 C++ API(Ha*)와 같은 기능의 Python API(hart 모듈)를 제공합니다. Python 이름은 Ha 접두사를
떼고 snake_case로 바꾼 것입니다. 영역별 진입점은 API 레퍼런스에,
디바이스 핸들 기반 API는 Driver API 레퍼런스에 정리되어 있습니다.
설치
hart는 단독 패키지로 설치되지 않으며, 컴파일러, 프로파일러, 프레임워크 통합 컴포넌트와 함께 단일
HyperAccel SDK wheel 패키지 형태로 배포됩니다.
자세한 설치 가이드와 필수 선행 조건인 KMD(커널 모드 드라이버) 설정은 SDK 설치 가이드를 참고하십시오.
호환성
본 문서는 hart 0.0.6 버전을 기준으로 작성되었습니다.
| 구분 | 검증된 버전 |
|---|---|
| Python | 3.10 – 3.12 |
| PyTorch | 2.10.0 |
| 디바이스 버전 | Bertha Cloud EVT0, Bertha Cloud EVT1, Bertha Edge EVT0 |
상세 사양은 지원 매트릭스를 참고하십시오.


