2. 실행 모델
런타임은 커널 코드를 해석하거나 최적화하지 않습니다. 컴파일된 커널을 디바이스에 로드하고, 전달받은 인자를 하드웨어 규격에 맞게 배치한 뒤 디바이스에 디스패치(Dispatch)합니다.
동기 API와 비동기 API는 이 디스패치 과정이 같고, 제어권을 돌려주는 시점만 다릅니다. 동기 API(예:
launch_kernel_with_binary_path()(C++: HaLaunchKernel()))는 작업이 끝날 때까지 기다렸다가 반환하므로,
반환되면 연산도 끝난 상태입니다. 비동기 API(예: launch_kernel_async_with_binary_path()
(C++: HaLaunchKernelAsync()))는 작업을 지정한 스트림에 넣자마자 반환하므로, 완료는 스트림이나 이벤트로
따로 확인해야 합니다(동기·비동기 디스패치).
이 문서는 커널 내부 연산이 아니라, 작업이 디스패치되는 방식과 호출이 반환되는 시점을 다룹니다.
Contents
| Section | Objective |
|---|---|
| 2.1 동작 모드 | 상위 프레임워크가 런타임을 구동하는 두 가지 모드(Compile, Eager)와 모드별 장단점 |
| 2.2 디바이스 관리 | 스레드가 작업할 디바이스를 고르는 방법과 디바이스 리셋 시 동작 |
| 2.3 커널 로딩과 실행 | 커널이 디바이스에 로드·캐싱되는 방식, 인자를 전달하는 방법(HaLaunchArgs), 파일 경로나 커널 라이브러리로 커널을 실행하는 방법 |
| 2.4 동기·비동기 디스패치 | 동기·비동기 API가 제어권을 돌려주는 시점과 작업 완료를 확인하는 방법 |
| 2.5 실행 시간 측정 시 주의 사항 | 직접 실행 시간을 잴 때 결과를 왜곡하는 세 가지 요인과 대처 방법 |
2.1 동작 모드
상위 프레임워크 계층은 두 가지 방식으로 런타임을 구동합니다. 이는 개별 API 호출의 플래그가 아니라, 상위 프레임워크 계층이 런타임을 구동하는 아키텍처적 진입 방식을 의미하며 방식별로 실행 오버헤드와 관측 가능성(Observability) 간의 트레이드오프가 존재합니다.
| 모드 | 동작 방식 | 디스패치 오버헤드 | 관측 가능성 | 주요 타겟 유스케이스 |
|---|---|---|---|---|
| Compile | 상위 컴파일러가 최적화한 모델 그래프의 실행 시퀀스를 그대로 받아 구동합니다. | Low | Limited | 프로덕션 인퍼런스 서빙 |
| Eager | 연산 호출 즉시 순차적으로 디바이스에 디스패치합니다. | High | Full | 초기 브링업, 연산 정확도 검증, 디버깅 |
예컨대 PyTorch 환경에서는 torch.compile(backend="legato") 인터페이스를 통해 이 선택이 수행되며, 컴파일 지원 구간은 Legato 커널로 오프로드되고 미지원 구간은 Eager 모드로 폴백(Fallback)됩니다. 관련 아키텍처 배경은 Compiler 문서를 참조하십시오.
시스템 브링업 및 단위 검증 단계에서는 Eager 모드를 활용하고, 그래프가 안정화된 프로덕션 단계에서는 Compile 모드로 전환하는 것을 권장합니다. Compile 모드 환경에서 발생하는 수치적 불일치나 이상 징후는 동일 입력에 대해 Eager 모드로 재실행하여 연산자 단위의 비교 진단을 수행해야 합니다.
2.2 디바이스 관리
디바이스 지정 (Device Assignment)
set_device()(C++: HaSetDevice())는 호출한 스레드의 현재 디바이스만 설정합니다. 다른 스레드에는 영향을 주지 않으며,
새로 만든 스레드도 이 설정을 물려받지 않습니다. 따라서 디바이스를 쓰는 스레드마다 먼저 set_device()를
호출해야 하며, 호출하지 않은 스레드에서 디바이스가 필요한 API를 호출하면 에러가 발생합니다.
1 2 | |
1 2 3 | |
- 유효 디바이스 ID(Device ID)의 범위는
[0, hart.get_device_count())이며, 0-based 인덱싱(0-based Indexing)을 따릅니다. - 멀티 스레드·멀티 프로세스 환경에서의 디바이스 오케스트레이션은 멀티 디바이스 프로그래밍에서 상세히 다룹니다.
리셋 메커니즘 (Device Reset)
reset_device()(C++: HaResetDevice())는 디바이스 하나를 초기 상태로 되돌리고, reset_all_devices()(C++: HaResetAllDevices())는 프로세스가 사용하는 모든 디바이스를 리셋합니다.
디바이스 리셋(Device Reset) 사용 시 주요 제약 및 주의사항
- 리소스 무효화: 리셋이 수행되면 해당 디바이스에 종속된 모든 할당(Allocation),
스트림, 이벤트 핸들이 즉시 무효화됩니다. 리셋 이전의 스트림·이벤트 핸들은
HaStreamInvalidHandle·HaEventInvalidHandle로 거부되고, 디바이스 포인터는 전송에서HaMemoryInvalidAddress, 해제에서HaMemoryFreeFailed로 거부됩니다. 단, 리셋 이후 새로 할당한 메모리가 같은 주소를 받으면 이전 포인터가 새 할당을 가리키게 되어 거부되지 않으므로, 사용자는 리셋 호출 시점에 연관 리소스를 명시적으로 정리해야 합니다. - 디바이스 재지정: 리셋한 디바이스를 다시 쓰려면 그 디바이스를 쓰던 스레드마다
set_device()를 다시 호출해야 합니다. 다시 지정하기 전에는 디바이스가 필요한 호출이HaDeviceInvalidArgument또는HaDeviceNotInitialized를 반환합니다. - 프로덕션 에러 복구 용도 부적합: 본 메커니즘은 매 반복마다 깨끗한 상태가 요구되는 단위 테스트 및 벤치마크 루프에 적합합니다. 다만 프로세스 전역에 영향을 주고, 다른 스레드가 사용 중인 디바이스까지 리셋하는 무거운 블로킹 연산이므로 프로덕션 서빙 환경의 에러 복구(Error Recovery) 용도로는 사용하지 마십시오.
2.3 커널 로딩과 실행
앞선 실행 모드와 무관하게, 디바이스에서 실제로 수행되는 최소 연산 단위는
커널(Kernel)입니다. 커널은 컴파일된 바이너리 파일의 경로, 또는 미리 컴파일된
커널 라이브러리에서 얻은 커널 핸들을 통해 로드 및 실행되며, 커널에 전달할 인자는 인자 목록
객체 HaLaunchArgs에 담아 넘깁니다. 인자 목록의 구성 방법은 아래 「커널 인자」 섹션에서,
라이브러리 사용법은 「커널 라이브러리와 핸들 실행」 섹션에서 설명합니다.
바이너리 로딩 및 캐싱 메커니즘 (Loading & Caching Behavior)
- 지연 로딩 (Lazy Loading): 커널 바이너리는 각 디바이스에서 처음 실행될 때 로드되며, 프로세스 동안 디바이스별로 한 번만 로드됩니다.
- 프로파일링 노이즈 방지 (Warm-up Strategy): 초기 실행 회차(First Iteration)에는 바이너리 로드 비용이 포함되므로, 해당 구간의 레이턴시 측정은 실제 연산 성능을 왜곡합니다. 정확한 벤치마킹을 위해서는 반드시 선행 워밍업(Warm-up) 단계를 거쳐야 합니다.
- 캐시 범위와 수명주기 (Cache Scope & Lifecycle): 이 커널 캐시는 디바이스별로 독립적으로 유지되며 프로세스 수명 동안 지속됩니다. 동일한 커널이라도 타겟 디바이스가 다르면 각 디바이스에서 별도로 로드됩니다. 디바이스 리셋은 커널 캐시를 포함해, 반복 연산의 오버헤드를 줄이기 위해 유지되던 모든 내부 리소스와 캐시를 통째로 초기화합니다. 자세한 내용은 위 리셋 메커니즘 섹션을 참고하십시오.
별도의 커널 로딩 API는 없습니다
대상 디바이스에 커널이 아직 로드되어 있지 않으면, 이어지는 「커널 실행」 섹션의
launch_kernel_with_binary_path()·launch_kernel_with_handle()(C++: HaLaunchKernel())를 호출할 때
로드됩니다. 커널 라이브러리를 등록하는 library_load_data()(C++: HaLibraryLoadData())도 디바이스에
커널을 올리지 않습니다.
커널 인자 (HaLaunchArgs)
HyperAccel 런타임에서 커널 실행 함수는 인자 목록 객체인 HaLaunchArgs(C++: HaLaunchArgs 클래스, Python:
hart.HaLaunchArgs)를 통해 인자를 일괄 전달받습니다.
인자 목록은 실행 회차에 사용할 인자들이 추가된 순서대로 관리됩니다. 호출부는 인자 목록 인터페이스(메서드)를 통해서만 인자를 다루므로 하부 커널의 ABI 레이아웃이 변경되더라도 상위 호출 코드는 영향을 받지 않습니다.
| Section | Objective |
|---|---|
| 인자 종류 및 데이터 규격 | Tensor, Scalar, Array 인자의 종류별 특성 및 규격 |
라우팅 및 코어 지정 (Route) |
Universal, Top, Core 라우팅 규칙 |
| 객체 수명 주기 및 해제 | 인자 목록의 생성, 실행 시점 읽기, 데이터 복사 및 해제 |
| 인자 목록 재사용 | 반복 실행 시 객체 재생성 없는 값 교체(Update) 패턴 |
| 스레드 안전성 | 여러 스레드에서 인자 목록을 공유할 때의 규칙과 인자 목록 간 독립성 |
| 검증 시점 및 오류 처리 | 인자 추가 시점과 커널 실행 시점의 이중 유효성 검증 |
인자 종류 및 데이터 규격
커널이 선언한 순서에 맞춰 추가하는 인자는 크게 세 가지 종류로 분류됩니다.
| 인자 종류 | 주요 메서드 (C++ / Python) | 담는 데이터 및 구조 | 주요 용도 |
|---|---|---|---|
| Tensor | HaLaunchArgsAddTensor() / add_tensor() |
디바이스 메모리 주소, 차원(dims), 원소 단위 오프셋 |
디바이스 메모리에 위치한 입출력 텐서 |
| Scalar | HaLaunchArgsAddScalar() / add_scalar() |
데이터 타입(HaDataType) 및 값의 비트 패턴 |
크기, 플래그, 계수 등의 단일 스칼라 값 |
| Array | HaLaunchArgsAddArray() / add_array() |
차원, 스트라이드(Stride), 원소 바이트(데이터) | 커널 인자 블록에 직접 적재할 소형 호스트 데이터 (디바이스 포인터 아님) |
Tensor 규격
Tensor 인자(HaLaunchArgsAddTensor() / add_tensor())에 적용되는 규칙입니다.
- 디바이스 주소(
da): 텐서 시작 위치의 디바이스 주소입니다. 인자 목록에는 주소 값만 기록되며, 텐서 데이터는 복사되지 않습니다. - 차원(
dims, C++는rank함께 전달): 커널이 선언한 순서대로 각 차원의 크기를 넘깁니다. 원소 타입은 커널이 선언한 대로 해석되므로 인자에 따로 지정하지 않습니다. - 오프셋(
offset):da로부터의 원소 단위 오프셋입니다. 지정하지 않으면0입니다(Python 기본값).
Scalar 규격
Scalar 인자(HaLaunchArgsAddScalar() / add_scalar())에 적용되는 규칙입니다.
- 지원 타입(
HaDataType):Int8,Int16,Int32,Int64,Float16,BFloat16,Float32,Float64,Float8(E4M3) - 비트 패턴 전달: 값은 비트 패턴 그대로 전달되며, 지정한 데이터 타입이 차지하는 하위 바이트만 읽습니다.
* 예: 음수
Int32는 하위 4바이트의 2의 보수,Float32는 하위 4바이트의 IEEE 754 비트 패턴입니다.
Array 규격
Array 인자(HaLaunchArgsAddArray() / add_array())에 적용되는 규칙입니다.
- 데이터(
raw_data): 원소 바이트를 그대로 넘깁니다(C++는 바이트 수raw_data_size함께 전달, Python은bytes·bytearray·memoryview). 이 바이트는 디바이스 메모리가 아니라 커널 인자 블록에 직접 들어가며, 원소 타입은 커널이 선언한 대로 해석됩니다. - 차원(
dims, C++는rank함께 전달): 커널이 선언한 순서대로 각 차원의 크기를 넘깁니다. - 스트라이드(
strides): 차원별 스트라이드입니다. 생략하면(C++:nullptr, Python:None) 단위 스트라이드로 처리합니다.
라우팅 및 코어 지정 (Route)
커널의 ABI는 Top Executor용 인자 블록 하나와 개별 코어별 인자 블록들로 구성되며, 각 실행 유닛은 자신에게
할당된 블록만 읽습니다. 인자마다 어느 블록에 기록할지를 HaLaunchArgRoute로 지정합니다.
| Route 지정 값 | 기록되는 대상 블록 | target_core 설정 값 |
|---|---|---|
Universal |
Top 블록 및 모든 코어 블록 | 무시됨 (-1 전달) |
Top |
Top 블록 전용 | 무시됨 (-1 전달) |
Core |
target_core로 지정된 코어 하나의 블록 |
코어 인덱스 (0부터, 현재 디바이스의 코어 수 미만). 여러 코어가 필요한 경우 코어별로 개별 추가 |
커널과 같은 route 사용
route는 커널을 컴파일할 때 정해진 값과 같아야 합니다. 다른 route로 추가한 인자는 커널이 읽지 않는
블록에 기록되어 커널이 잘못 동작합니다.
객체 수명 주기 및 해제
인자 목록은 목록 생성 → 인자 추가 → 커널 실행 순서로 사용하며, 값을 교체(Set*)해 다시 실행할 수
있습니다. 해제는 객체가 소멸할 때 자동으로 이루어집니다.
- 실행 시점의 즉시 읽기: 실행 함수(
HaLaunchKernel(),HaLaunchKernelAsync())는 제어를 반환하기 전에 호출 스레드 상에서 인자 목록을 전부 읽어 실행 명령을 빌드합니다. 스트림에는 생성된 명령만 등록됩니다. - 비동기 실행 시 수명: 비동기 실행이라 하더라도 실행 호출이 반환된 직후에 인자 목록을 해제하거나 내부 값을 변경해도 안전합니다.
- 인자 데이터 복사: 인자를 추가하거나 교체할 때(
Add*,Set*) 함께 넘긴dims,strides, Array의 호스트 데이터는 그 시점에 인자 목록 내부로 복사됩니다. 따라서 호출이 반환되면 원본 호스트 버퍼를 바로 해제하거나 변경해도 됩니다. Tensor의 디바이스 주소는 값만 기록되며, 가리키는 디바이스 메모리는 실행이 끝날 때까지 유효해야 합니다. - 생성과 해제: C++의
HaLaunchArgs는 인자 레코드를 소유하는 객체입니다. 객체를 생성하면 빈 목록이 만들어지고, 스코프를 벗어나 소멸할 때 레코드가 해제되므로 별도의 해제 호출이 필요 없습니다. 오류로 일찍 반환하는 경로에서도 자동으로 해제됩니다. Python 객체도 소멸할 때 자동으로 해제됩니다. - 이동 전용: C++ 객체는 복사할 수 없고 이동만 할 수 있습니다. 이동된 뒤의 객체를 인자 목록 함수나 실행
함수에 넘기면
HaKernelInvalidArgument로 거부됩니다. 생성 시 메모리가 부족하면std::bad_alloc이 발생합니다.
인자 목록 재사용
동일한 형태의 인자 구조로 커널 실행을 반복할 때는 매번 객체를 새로 생성하지 않고 기존 목록 객체를 유지한 채 값만 교체(Update)하는 패턴을 권장합니다.
- 업데이트 메서드:
set_tensor(),set_scalar_bits(),set_array()(C++:HaLaunchArgsSetTensor(),HaLaunchArgsSetScalarBits(),HaLaunchArgsSetArray()) - 동작 방식: 인자가 추가된 순서(인덱스
0부터 시작)를 기준으로 지정된 인자의 주소, 차원, 값을 교체합니다. - 제약 사항:
route,target_core, 데이터 타입, 오프셋은 최초 추가된 값이 유지되며, 차원 수(rank)는 변경할 수 없습니다.
스레드 안전성
- 목록 공유: 여러 스레드가 한 목록으로 동시에 실행하거나, 인자를 추가·교체할 수 있습니다. 목록마다 잠금이 있어 추가·교체는 배타적으로, 실행은 공유 모드로 목록을 읽으므로, 겹친 호출은 어떤 순서로든 하나씩 처리됩니다. 다만 실행이 겹친 교체 중 어느 것을 반영하는지는 정해져 있지 않으므로, 실행에 쓸 값은 실행 전에 확정해 두십시오.
- 이동·소멸: 목록의 이동과 소멸은 동기화되지 않습니다. 다른 스레드가 사용 중인 목록을 이동하거나 소멸시키지 마십시오.
- Python: Python 객체도 같은 규칙을 따르므로, 한 객체를 여러 스레드에서 함께 써도 됩니다.
- 독립성: 서로 다른 인자 목록 객체끼리는 공유하는 상태가 없습니다.
검증 시점 및 오류 처리
인자는 두 시점에서 검증됩니다.
인자를 추가할 때는 호출 스레드의 현재 디바이스(HaSetDevice() / set_device())를 기준으로 검사합니다.
예를 들어 Core route의 코어 번호는 현재 디바이스에 있는 코어여야 합니다. 따라서 인자를 추가하기 전에 현재
디바이스를 지정해야 하며, 지정하지 않으면 HaDeviceNotInitialized, 디바이스 리셋이 진행 중이면 HaDeviceNotReady가
반환됩니다. 현재 디바이스가 아닌 디바이스를 기준으로 목록을 만들려면 드라이버 API의 ha_drv_launch_args_add_*()로
디바이스를 직접 지정합니다. 인자를 교체할 때(Set*)는 이미 담긴 레코드의 값만 바꾸므로 디바이스가 필요 없습니다.
현재 디바이스가 없거나 리셋이 진행 중이어도 교체할 수 있습니다.
인자 목록은 특정 디바이스에 묶이지 않으므로, 커널을 실행할 때 실행하는 디바이스를 기준으로 다시 검사합니다. 실행하는 디바이스에 없는 코어를 가리키는 인자가 있으면 실행이 거부됩니다. 코어 범위만 맞으면 목록을 만들 때와 다른 디바이스에서도 실행할 수 있습니다. 따라서 잘못된 인자는 추가 시점과 실행 시점 중 한 곳에서 반드시 오류로 보고됩니다.
| 검증 시점 | 감지하는 오류 유형 | 발생 결과 |
|---|---|---|
| 1. 인자 추가 및 교체 시점 | 추가 시 현재 디바이스 미지정(HaDeviceNotInitialized)·디바이스 리셋 진행 중(HaDeviceNotReady), 지원하지 않는 데이터 타입, 잘못된 route, 현재 디바이스에 없는 코어 번호, 음수 rank, 교체 시 종류·rank 불일치, 이동된 목록 |
해당 메서드 호출이 오류 코드 반환 (Python: RuntimeError), 인자 목록은 변경되지 않음 |
| 2. 커널 실행 시점 | 커널이 선언한 인자와 종류·데이터 타입·개수가 다른 인자, 실행 디바이스에 없는 코어 번호 | 커널 실행이 HaKernelInvalidArgument로 즉시 거부되며, 로그에 기대 규격과 전달된 규격의 상세 내역이 기록됨 |
함수별 오류 조건은 Execution API 레퍼런스(Python:
HaLaunchArgs)에 정리되어 있습니다.
커널 실행 (Kernel Execution)
1 2 3 4 5 | |
1 2 3 4 5 6 7 | |
인자 목록 재사용 예제
다음은 Python 환경에서 HaLaunchArgs 객체를 생성하고, 인자를 바인딩한 뒤 반복 루프 내에서 주소와 값을
갱신하여 비동기 실행하는 전형적인 패턴입니다.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | |
커널 라이브러리와 핸들 실행 (Kernel Library)
커널 라이브러리를 사용하면 커널을 파일 경로 대신 이름으로 찾아 실행할 수 있습니다. 순서는 다음과 같습니다.
- 등록:
library_load_data()(C++:HaLibraryLoadData())로 라이브러리를 등록하고 라이브러리 핸들(HaLibrary_t)을 받습니다. 디바이스를 사용하지 않으며, 호출할 때마다 새 라이브러리가 등록되므로 라이브러리마다 프로세스에서 한 번만 호출하십시오. - 커널 조회:
library_get_kernel()(C++:HaLibraryGetKernel())로 이름에 해당하는 커널 핸들(HaKernel_t)을 얻습니다. 같은 이름은 항상 같은 핸들을 돌려주며, 이 핸들은 어느 디바이스에서 실행하든 같습니다. - 실행:
launch_kernel_with_handle()/launch_kernel_async_with_handle()(C++:HaLaunchKernel(kernel, args)/HaLaunchKernelAsync(kernel, args, stream))로 실행합니다. 디바이스마다 첫 실행 때 그 디바이스의 칩 세대에 맞는 빌드가 로드되며, 라이브러리에 그 칩 세대용 빌드가 없으면HaKernelNoBinaryForDevice를 반환합니다.
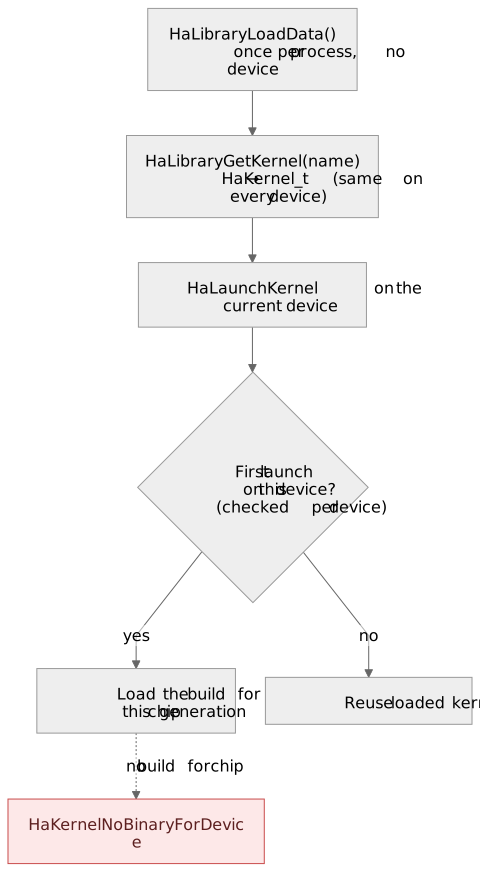
커널 라이브러리의 등록, 조회, 디바이스별 로드 흐름 (C++ API 기준)
라이브러리 핸들과 커널 핸들은 프로세스가 끝날 때까지 유효하며 디바이스 리셋 후에도 그대로 쓸 수 있습니다. 리셋 뒤 첫 실행에서 커널이 다시 로드됩니다.
1 2 3 4 5 6 7 8 9 10 | |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | |
API 상세는 C++ Execution API와 Python Execution API를 참고하십시오.
2.4 동기·비동기 디스패치
런타임은 커널 실행 및 메모리 연산에 대해 동기 및 비동기 디스패치 방식을 모두 지원합니다.
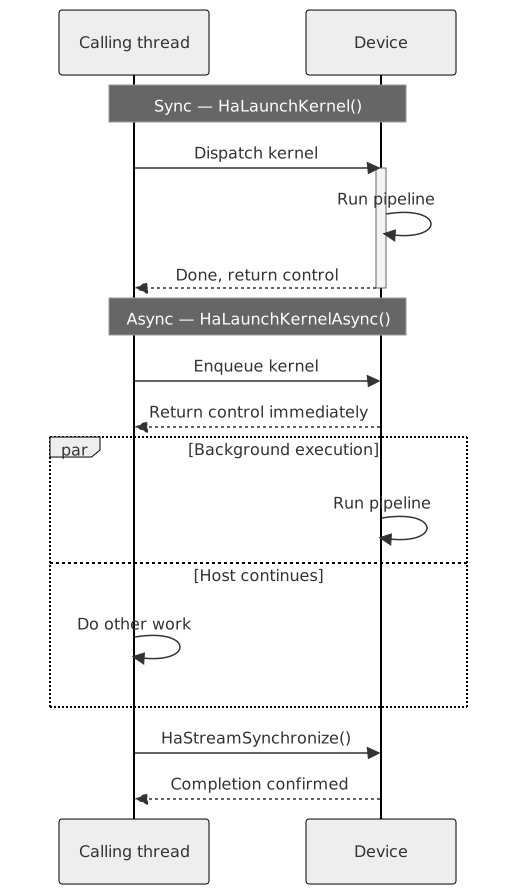
동기 디스패치와 비동기 디스패치의 제어권 반환 시점
동기 (Synchronous)
launch_kernel_with_binary_path()(C++: HaLaunchKernel())는
디바이스에서 커널 실행이 끝난 뒤에 반환합니다.
1 | |
비동기 (Asynchronous)
launch_kernel_async_with_binary_path()(C++: HaLaunchKernelAsync())는
커널 실행을 스트림에 넣는 즉시 반환되며, 완료 여부는 스트림이나
이벤트로 확인해야 합니다.
1 2 | |
주의 및 측정 가이드
호출 시점만을 샘플링하는 일반적인 프로파일러는 비동기 실행에 대해 실제 연산 시간 대신 큐잉(Queueing) 시간만을 관측하게 됩니다. 따라서 정확한 디바이스 실행 시간은 반드시 스트림이나 이벤트 경계를 기준으로 측정해야 합니다. 디바이스 실행 구간을 타임라인으로 확인하려면 HyperAccel Profiler를 사용하십시오.
주의: 동기화 전 호스트 버퍼 접근
비동기 호출은 작업을 스트림에 넣은 직후 반환되므로, 반환 시점에는 디바이스 작업이 끝나지 않았을 수 있습니다. 이때 작업에 넘긴 호스트 버퍼를 읽으면 결과가 반영되기 전의 값을 읽게 되고, 수정하거나 해제하면 작업 결과가 잘못될 수 있습니다. 호스트 버퍼는 스트림이나 이벤트로 완료를 확인한 뒤에 사용하십시오.
2.5 실행 시간 측정 시 주의 사항
프로파일러 없이 직접 실행 시간을 잴 때 결과를 수 배 이상 왜곡할 수 있는 세 가지 요인과 대처 방법을 다룹니다. 디바이스 실행 구간을 타임라인으로 확인하려면 HyperAccel Profiler를 사용하십시오.
계측 포인트 선정 오류 (Measurement Point Misconfiguration)
비동기 디스패치 API 호출부를 단순 래핑(Wrapping)할 경우, 실제 디바이스 연산 시간이 아닌 호스트 측 커맨드 큐잉 오버헤드만 계측되는 오류가 발생합니다.
1 2 3 4 5 6 7 8 9 10 11 12 | |
1 2 3 4 5 6 7 8 9 10 | |
특정 파이프라인 구간의 국소적 지연(Granular Latency)을 프로파일링할 때는 스트림 전체를
블로킹하는 전역 동기화 대신 이벤트(Event) 객체를 활용해야 합니다.
HaStreamSynchronize()는 해당 스트림 내의 모든 대기 작업을 일괄 동기화하므로,
특정 구간이 아닌 전체 파이프라인의 레이턴시가 측정되는 왜곡을 유발합니다.
콜드 스타트 및 초기화 오버헤드 (First Iteration Distortion)
첫 실행(First Iteration)에는 정상 상태(Steady-state) 실행에는 없는 일회성 초기화 비용이 더해지므로, 먼저 워밍업을 실행하고 그 결과는 측정에서 제외하십시오.
| 구분 (Category) | 요인 및 상세 메커니즘 | 벤치마킹 영향 및 대응 방안 |
|---|---|---|
| 바이너리 로딩 (Binary Loading) | • 메커니즘: 타겟 디바이스별 최초 실행 시 바이너리 로드 및 캐시 적재 수행 • 실행 경로: 바이너리 파일 읽기·검사와 디바이스 메모리 확보는 호출 스레드에서 수행되고, 바이너리를 디바이스로 복사하는 작업은 첫 실행의 스트림에 들어감 |
• 왜곡 영향: 초기 실행 회차에 극단적인 지연 시간(Outlier) 유발 • 대응 방안: 단순 첫 회차 배제만으로는 불충분하며, 바이너리 캐싱 완료를 위한 사전 워밍업 필수 |
| 초기 할당 및 캐싱 (Initial Allocation) | • 메커니즘: 풀이 비어 있는 초기 메모리 요청은 디바이스 메모리를 새로 확보하는 콜드 패스(Cold-path) 유발 • 정상화: 이후 동일 규격의 요청은 내부 캐시와 최적화된 재사용 경로를 통해 즉시 처리 |
• 왜곡 영향: 초기화 노이즈가 혼입되어 샘플 사이즈를 늘려도 통계적 수렴 방해 • 대응 방안: 내부 캐시 컨디셔닝(Conditioning)이 완료될 때까지 충분한 사전 예비 실행(Warm-up Cycle) 선행 |
반복 측정 간 상태 리셋 및 격리 메커니즘 (State Isolation & Reset Side-effects)
회차마다 완전한 초기 상태로 되돌리려는 시도는 아래 네 가지 이유로 측정하려는 연산보다
비용이 크고 측정 결과도 왜곡합니다. 따라서 반복 측정 루프 내부에서는
reset_device()(C++: HaResetDevice())를 사용하지 않는 것이 원칙입니다.
- 핸들 무효화로 인한 해체 및 재생성 유발:
HaResetDevice()는 해당 디바이스의 모든 할당된 리소스, 스트림, 이벤트 핸들을 무효화하여 사실상 디바이스의 실행 상태 전체를 초기화합니다. 따라서 루프 내부에서 호출할 경우 매 회차 스트림과 리소스를 처음부터 다시 생성해야 하며, 이 재생성 비용이 본래 측정하려는 연산 부하를 완전히 압도하게 됩니다. - 캐시 플러시와 바이너리 리로드: 디바이스 리셋은 내부 캐시 또한 강제로 플러시(Flush)합니다. 이로 인해 리셋이 포함된 루프는 매 회차 바이너리 리로드 비용을 유발하여, 앞서 다룬 초기화 오버헤드 문제가 매번 재발생하는 악순환으로 이어집니다.
- 자원 재사용 구조로 인한 격리 확보의 한계:
HaMemFree()를 통한 명시적 자원 반환 이후에도 내부 캐싱 및 재사용 정책에 기인한 잔류 상태(Residual State)가 유지되므로, 반복 회차 간 완전한 상태 격리(State Isolation)를 보장받을 수 없습니다. 나아가 이를 물리적으로 강제하고자 매 루프마다HaResetDevice()를 동원하는 것은 치명적인 오버헤드를 유발할 뿐이므로, 벤치마크 루프 내부의 상태 초기화 시도는 실효성이 없습니다. - 멀티 스레드 환경에서의 리셋: 리셋은 같은 디바이스를 사용하는 다른 스레드를 멈추지 않습니다. 리셋이
진행되는 동안 다른 스레드가 그 디바이스에 하는 호출은
HaDeviceNotReady를 반환하며, 동기화를 기다리던 호출도HaDeviceNotReady로 끝납니다. 리셋이 끝나면 다른 스레드가 가진 스트림·이벤트 핸들과 디바이스 포인터도 무효가 됩니다. 그 결과 어느 회차가 실패했는지, 측정값이 유효한지 판별하기 어려워집니다. 여러 스레드가 같은 디바이스를 쓰는 측정이라면 모든 스레드의 작업을 멈추고 동기화한 뒤에 리셋하십시오.
따라서 사전 워밍업 이후 형성된 캐싱 및 정상 상태는 억지로 제거하려 하지 말고 그대로 측정하는
편이 실제 프로덕션의 정상 상태(Steady-state) 퍼포먼스를 반영하는 데 훨씬 부합합니다.
HaResetDevice()는 루프 내부가 아닌, 서로 다른 실험 설정을 변경하며 별도의
벤치마크를 분리 실행하는 루프 외곽의 경계에서만 제한적으로 사용해야 합니다.